OPC 中国 · AI 日报
Claude、GPT-6更新与云栖新进展
24条AI动态:先国外11条,再国内13条。聚焦模型与额度更新、Seedance样片工作流、云栖大会及智能体工具,附逐条原图与来源。
本节目由酷恩选题与编辑,使用AI配音、酷恩02数字卡通形象,以及逐条标明来源的官方演示、厂商配图、原网页截图或原视频实帧。
本期目录 · 先国外,后国内
- Opus 5.5 发布
- GPT-6 Sol 与 Luna
- Claude Code 增加额度
- Google AI 订阅加入 Colab
- Codex 发放额度重置
- GPT-6 提示缓存升级
- Jev 从模型走向工具链
- Batch API 正式上线
- Transformers 直接运行 GGUF
- Isaac ROS 5.0 发布
- 车内 Grok 增加任务能力
- Seedance 2.5 样片模式
- 混元图像 3.5 预览版
- Qwen 4 已进入训练
- Ming 开源图像设计模型
- Kimi 浏览器扩展更新
- 真武 V900 公布
- Qwen 更新语音模型家族
- Qwen Intelligence 发布
- Qwen 披露芯片相关实验
- 阿里云推出 AgentCore
- MiMo-V2.6 技术进展
- 千问眼镜与耳机开启预约
- Kimi K3 接入 Bedrock
国外新闻
01 / 模型发布
Opus 5.5 发布
新模型API每百万Token输入4美元、输出20美元、缓存读取0.20美元;官方称典型任务成本较Opus 5降低40%。
先看模型更新。Anthropic 发布 Claude Opus 5.5,重点是长时间智能体任务的效率。标准 API 每百万 Token 输入四美元、输出二十美元,比 Opus 5 的单价降低百分之二十。结合完成任务所需的 Token 变化,官方称典型任务成本下降百分之四十。开发者可以分别比较单价和整项任务开销,再决定切换哪些工作流。
缓存读取价格为每百万 Token 0.20 美元。单价降幅与完成一次任务的总成本采用不同口径;快速模式另行计费,生物与网络安全相关能力执行专项限制。
原始来源:Anthropic ↗
02 / 模型发布
GPT-6 Sol 与 Luna
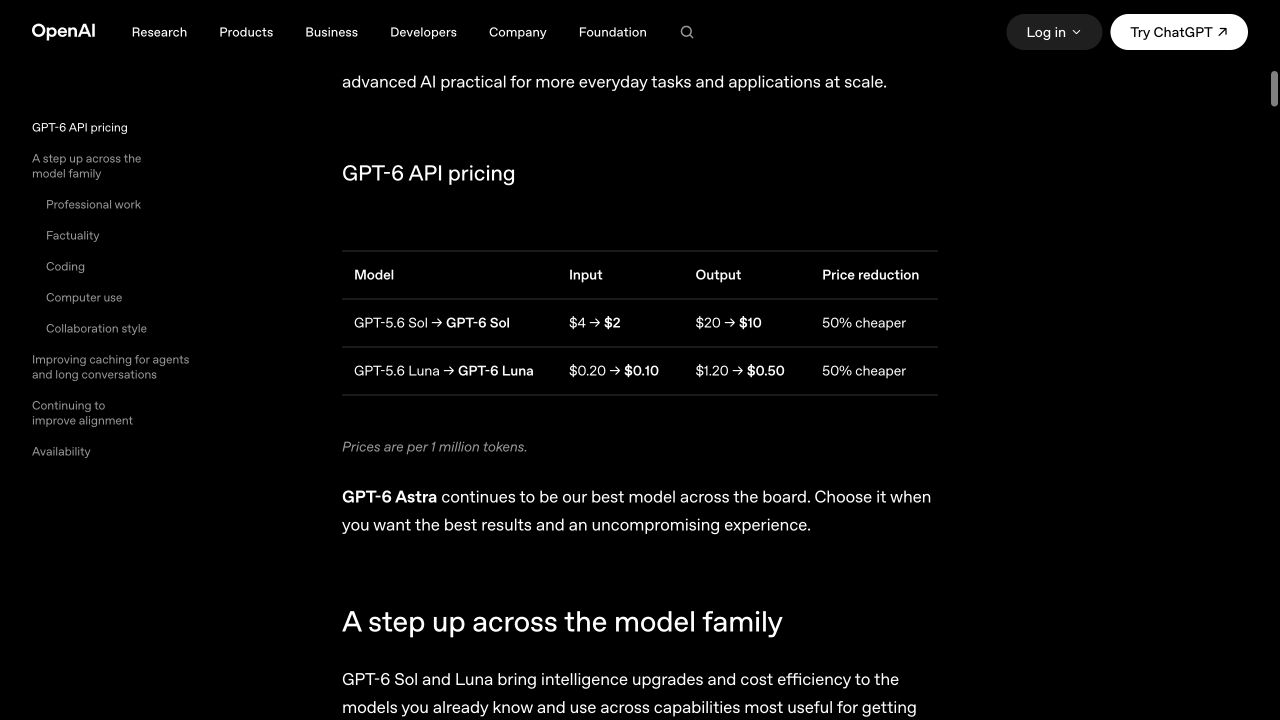
API每百万Token输入/输出:Sol为2/10美元,Luna为0.10/0.50美元;同步向ChatGPT Work与Codex逐步开放。
OpenAI 同期推出 GPT-6 Sol 和 Luna。标准 API 每百万 Token,Sol 输入两美元、输出十美元;Luna 输入零点一美元、输出零点五美元。两个模型正逐步进入 ChatGPT Work 和 Codex;免费版和 Go 用户可在桌面端使用 Luna。此次先落在工作和编程入口,普通 Chat 对话入口还未开放。
Sol 与 Luna 的工作入口按账户分批开放,Free 和 Go 的桌面端权益包括 Luna。模型能力数据来自 OpenAI 官方评测;团队可结合真实任务比较质量、速度和调用成本。
原始来源:OpenAI ↗
03 / 额度与权益
Claude Code 增加额度
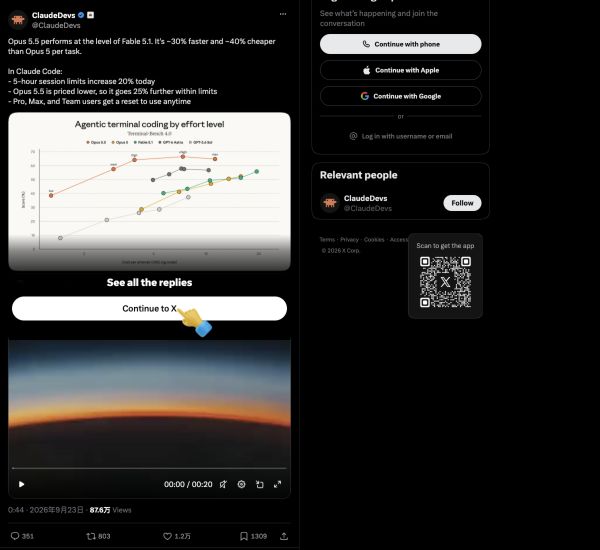
官方开发者账号称Claude Code五小时会话额度提高20%,Opus 5.5更低计价让额度更耐用;Pro、Max、Team用户获得可择时使用的重置。
模型更新也带来了订阅权益变化。Claude 官方开发者账号宣布,Claude Code 的五小时会话额度提高百分之二十。Opus 5.5 更低的计价,也让原有额度能覆盖更多工作。Pro、Max 和 Team 用户另外获得一次可以留到需要时使用的额度重置,适合把机会留给集中开发的时段。
这次公告分别涉及五小时会话额度、模型计价和一次可留存重置。Pro、Max、Team 的用户可以在账户中查看重置机会,并按自己的开发安排选择使用时间。
原始来源:Claude Developers ↗
04 / 额度与权益
Google AI 订阅加入 Colab
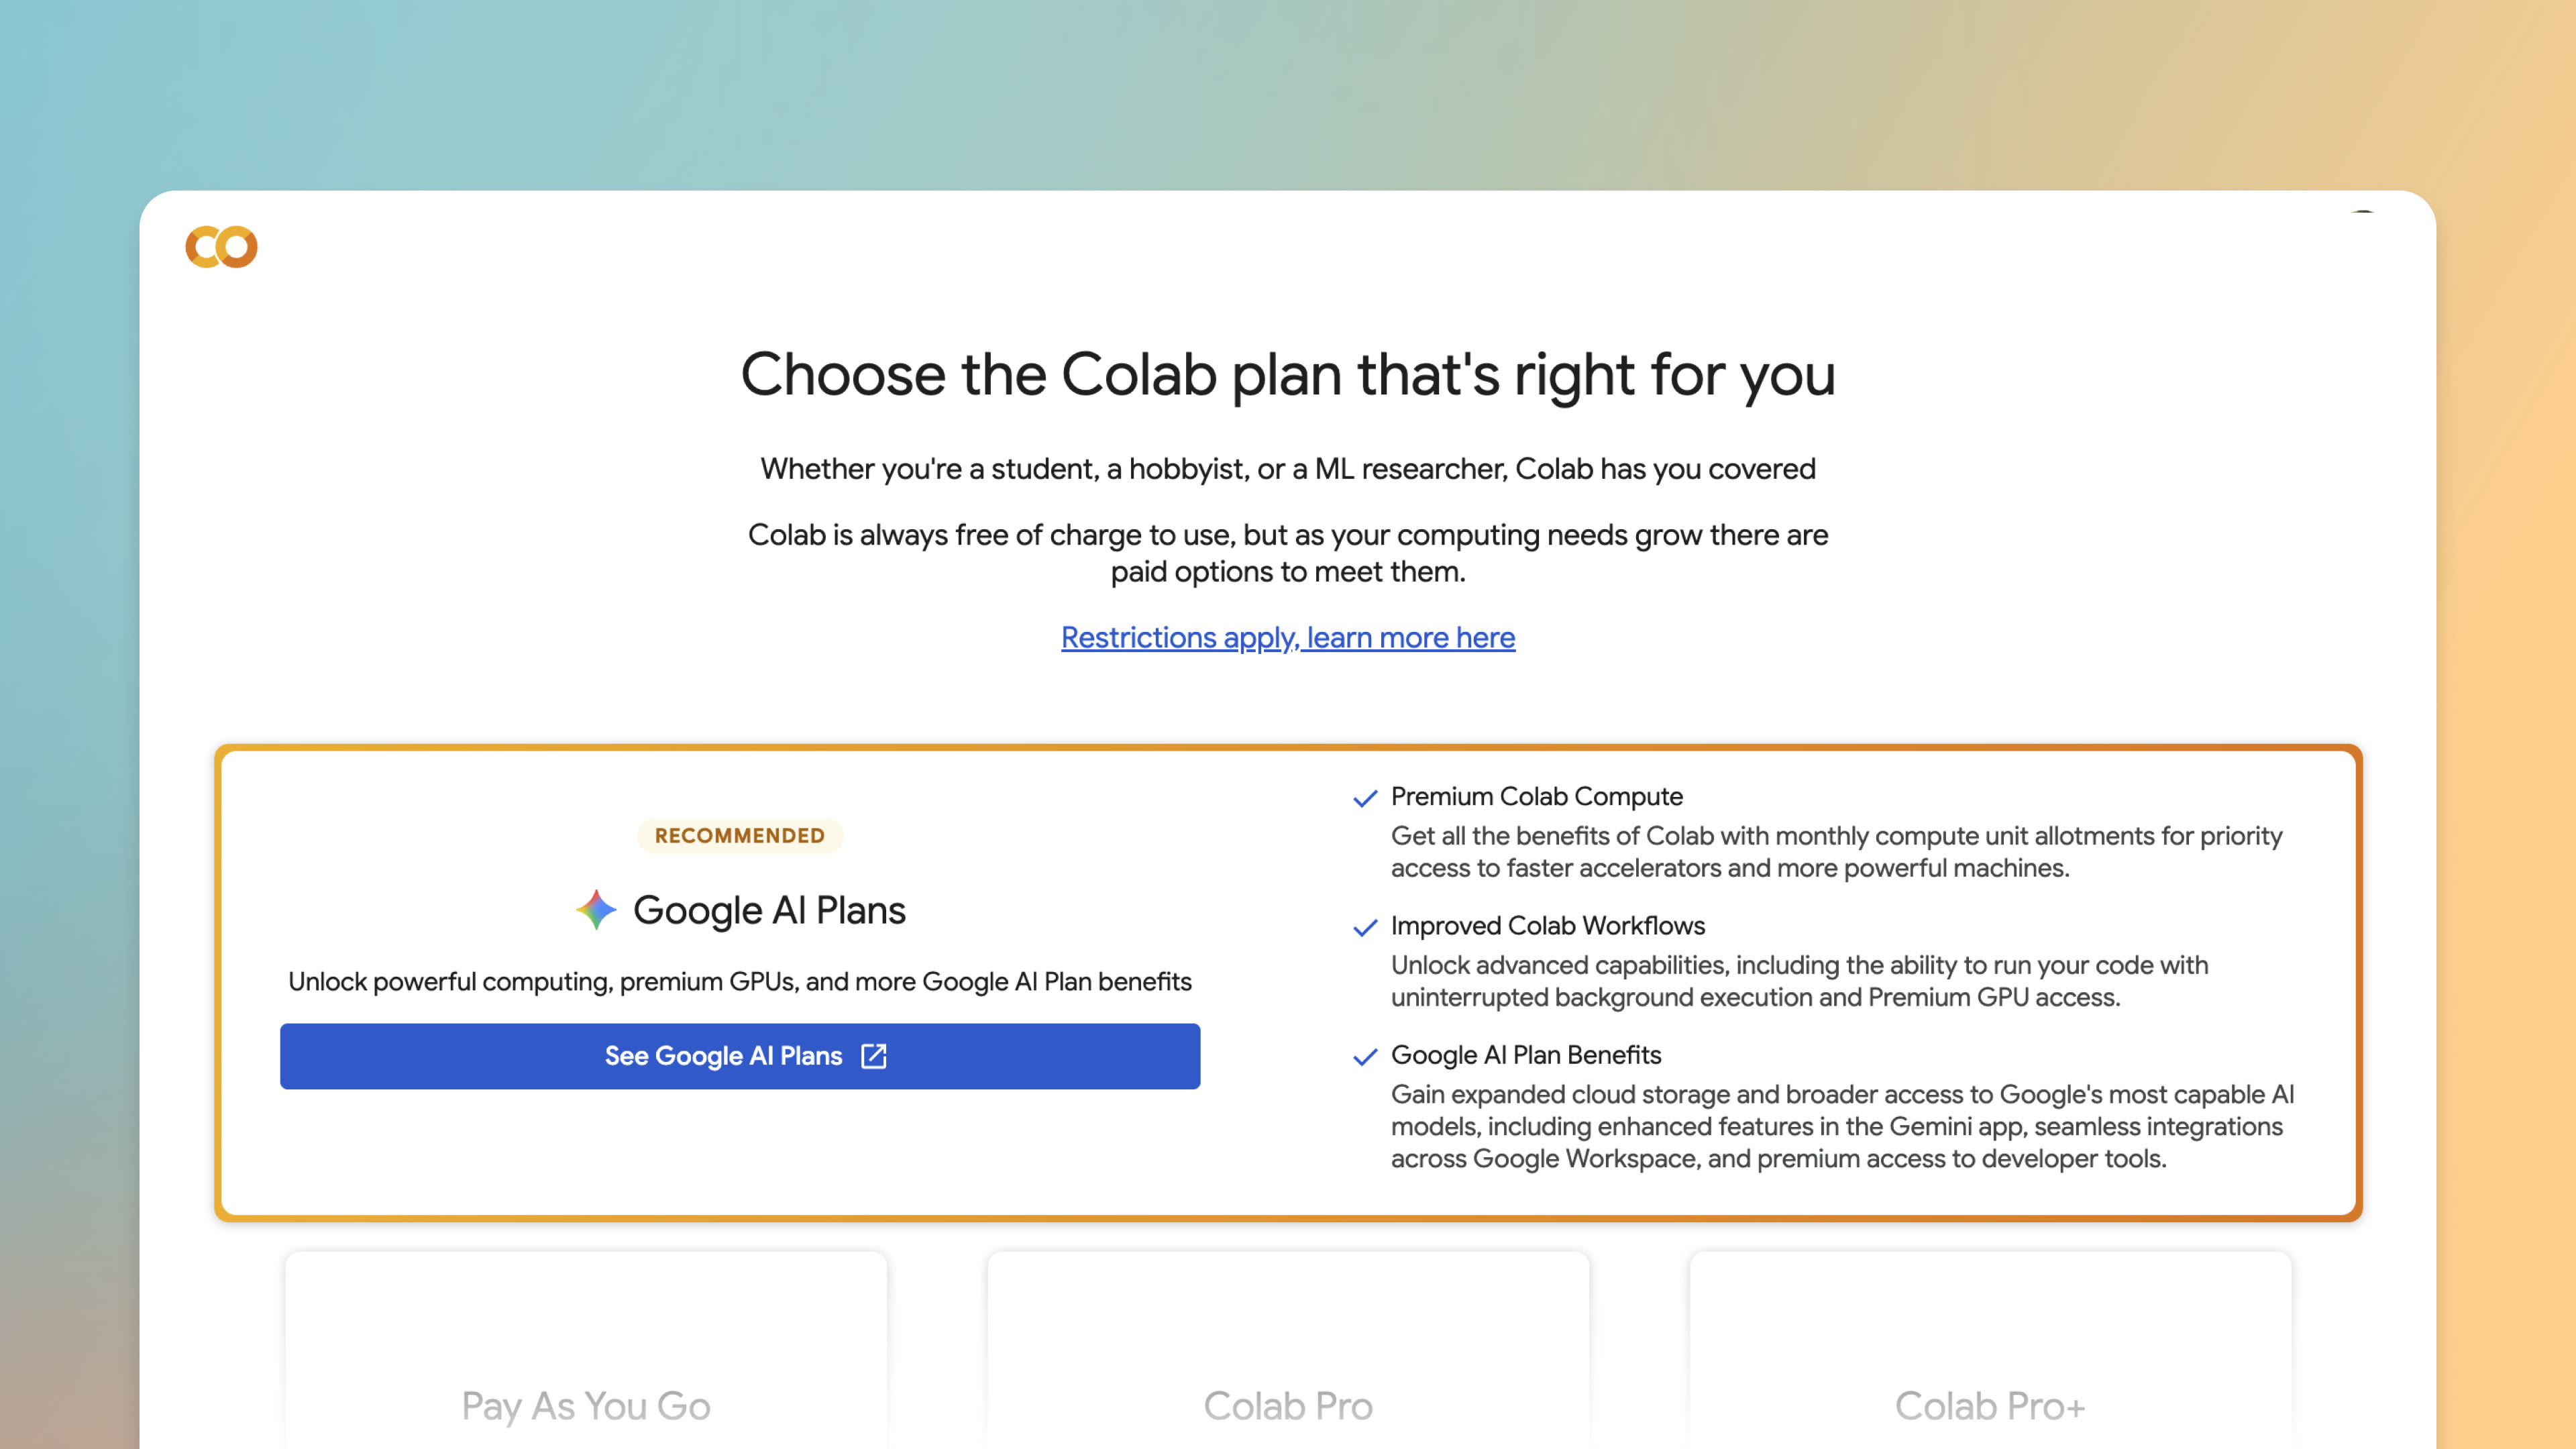
Google AI订阅增加Colab的更快加速器与高配机器优先访问;Ultra增加后台持续执行及Premium GPU访问。
Google 则把 Colab 纳入 Google AI 订阅权益,增加更快加速器和高配置机器的优先访问。Ultra 用户还能使用后台持续执行和高级 GPU,方便运行更长的计算任务。新权益将在 Colab 支持的地区逐步推出;已有 Colab 订阅继续保留,并可与 Google AI 权益叠加。
新权益将在 Colab 支持地区的未来几周逐步推出。现有 Colab 订阅继续保留,并可以和 Google AI 计划的权益叠加;具体加速器供给取决于方案与资源状态。
原始来源:Google Developers ↗
05 / 额度与权益
Codex 发放额度重置
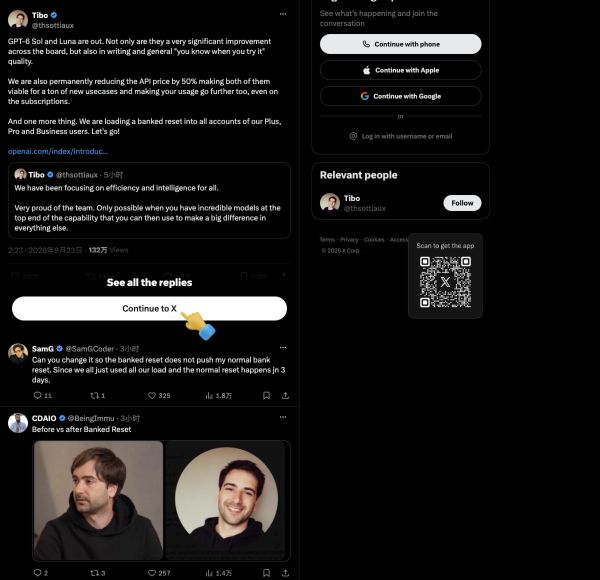
Codex负责人随Sol、Luna发布宣布,为Plus、Pro和Business账号发放一次可留存使用的重置机会。
Codex 负责人也随 Sol 和 Luna 的发布宣布,向 Plus、Pro 和 Business 用户发放一次可留存的额度重置。用户可以在真正需要继续工作时再使用,具体到账情况以账号页面为准。这项调整给模型切换和集中编码留出了更多试用空间。
本次发放范围为 Plus、Pro 与 Business。重置机会可以留待需要时使用,用户可在自己的账户额度页面查看实际到账情况。
06 / 开发工具
GPT-6 提示缓存升级
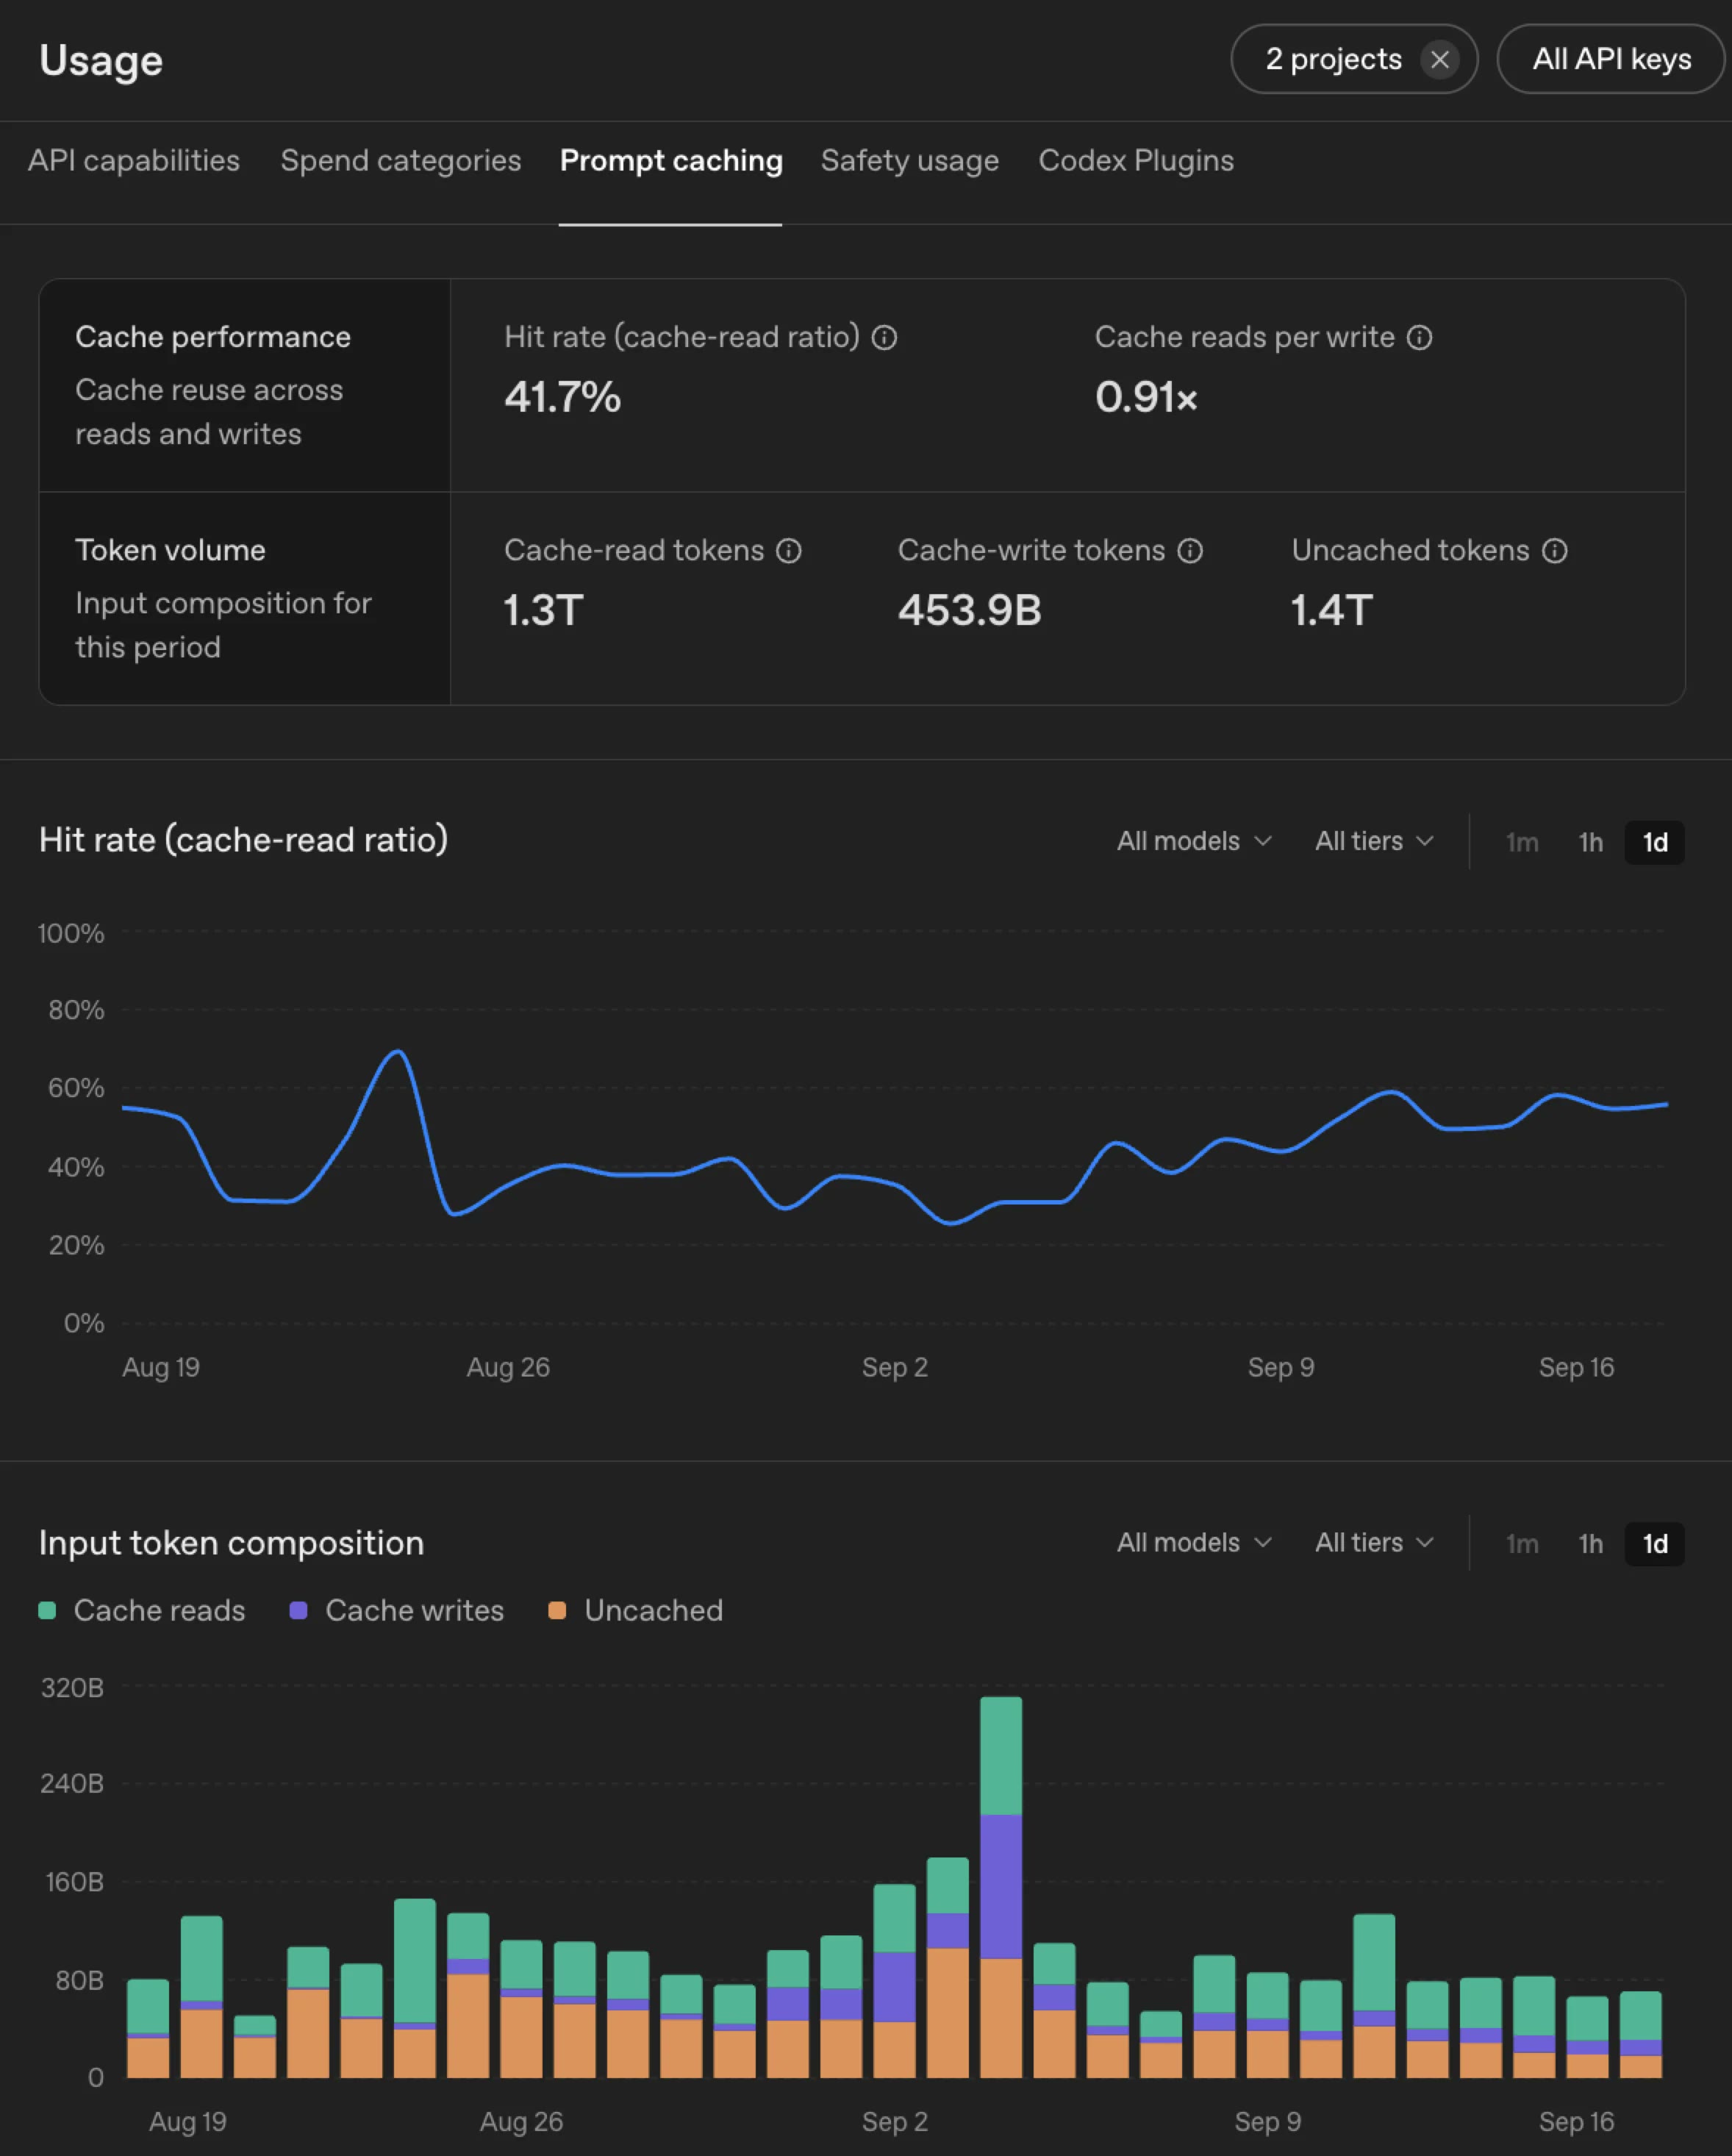
符合条件的共享前缀可在30分钟窗口内复用,缓存输入最高优惠90%;新增命中面板、诊断、显式断点与预热。
再看开发成本。OpenAI 为 GPT-6 更新提示缓存,符合条件的共享前缀可在三十分钟窗口内复用,命中的缓存输入最高优惠百分之九十。新增命中情况面板、诊断工具和显式断点,帮助开发者检查哪些上下文真正被复用。对长文档和重复工作流,缓存策略可以和模型选择一起优化。
缓存折扣针对实际命中的输入 Token。开发者可以结合命中面板与诊断,检查共享上下文是否复用,再按官方接口设计推理强度与工具配置。
原始来源:OpenAI ↗
07 / 智能体开发
Jev 从模型走向工具链
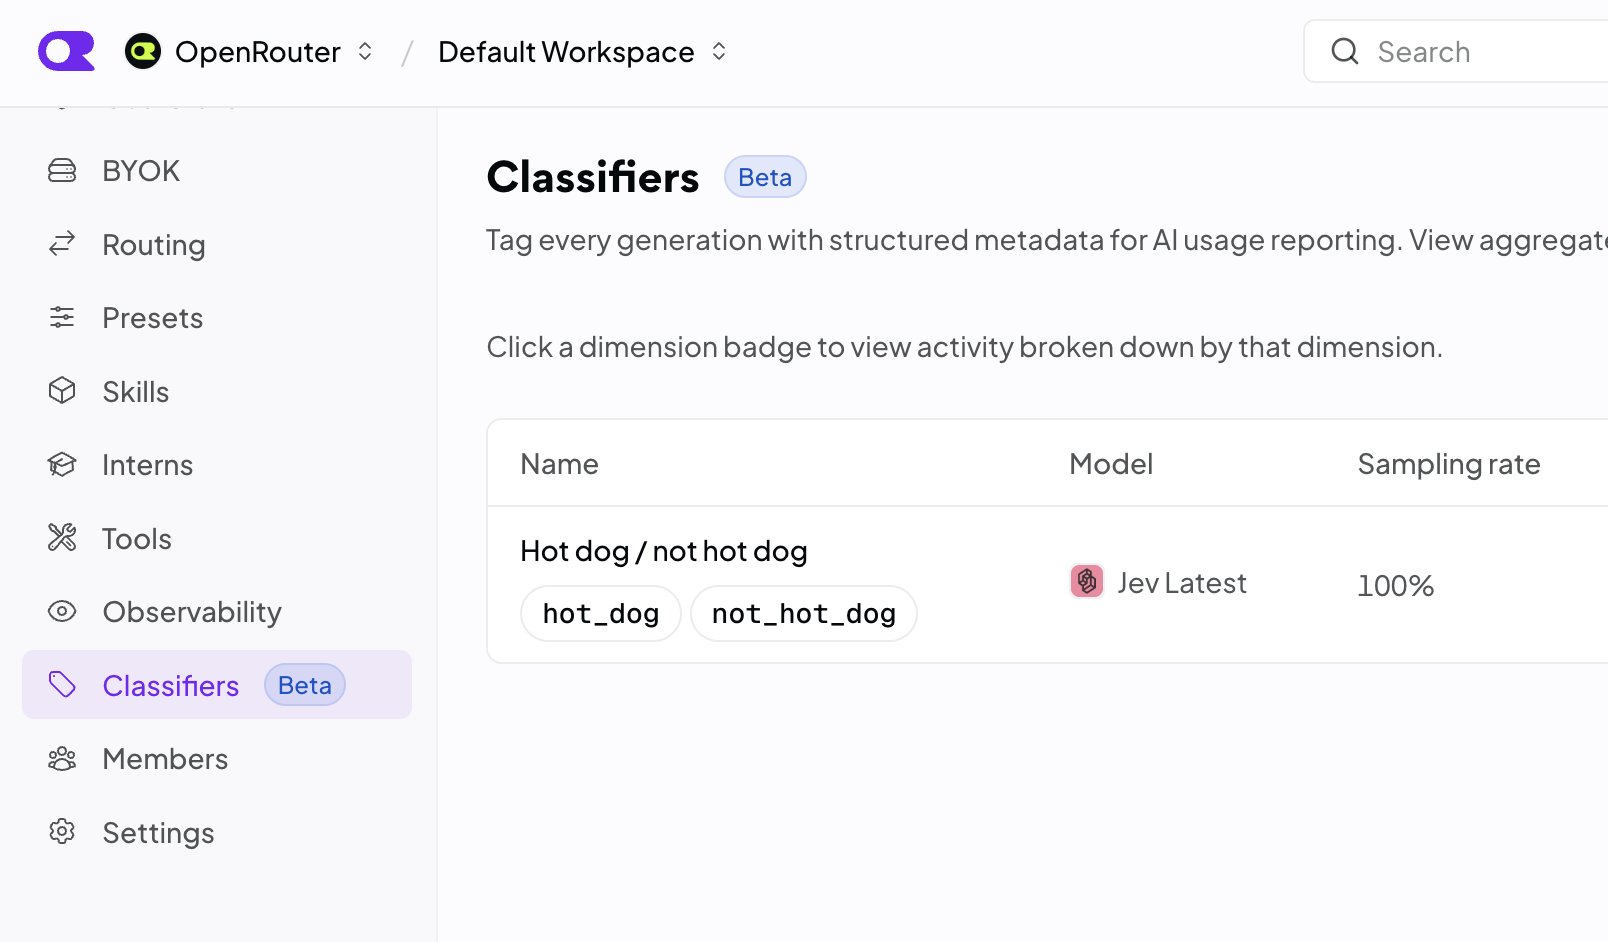
OpenClaw官方介绍让Jev参与工具选择、上下文压缩等程序内判断的插件方向;OpenRouter展示请求分类入口,LLM社区也出现接入插件。
近期高热的 Jev,正在进入更多工具链。OpenClaw 官方介绍了用决策模型参与工具选择、上下文压缩等程序内判断的插件方向;OpenRouter 则展示了请求分类入口。Jev 的输出是程序可以直接使用的类型化判断。对开发者来说,值得观察的是它如何嵌入现有流程,以及具体环节能否节省延迟和成本。
OpenClaw 介绍的是决策模型的插件设计与探索,OpenRouter 则给出了分类入口。Jev 返回的是类型化判断,适合嵌入工具选择、路由与上下文管理等程序环节。
08 / 价格与API
Batch API 正式上线
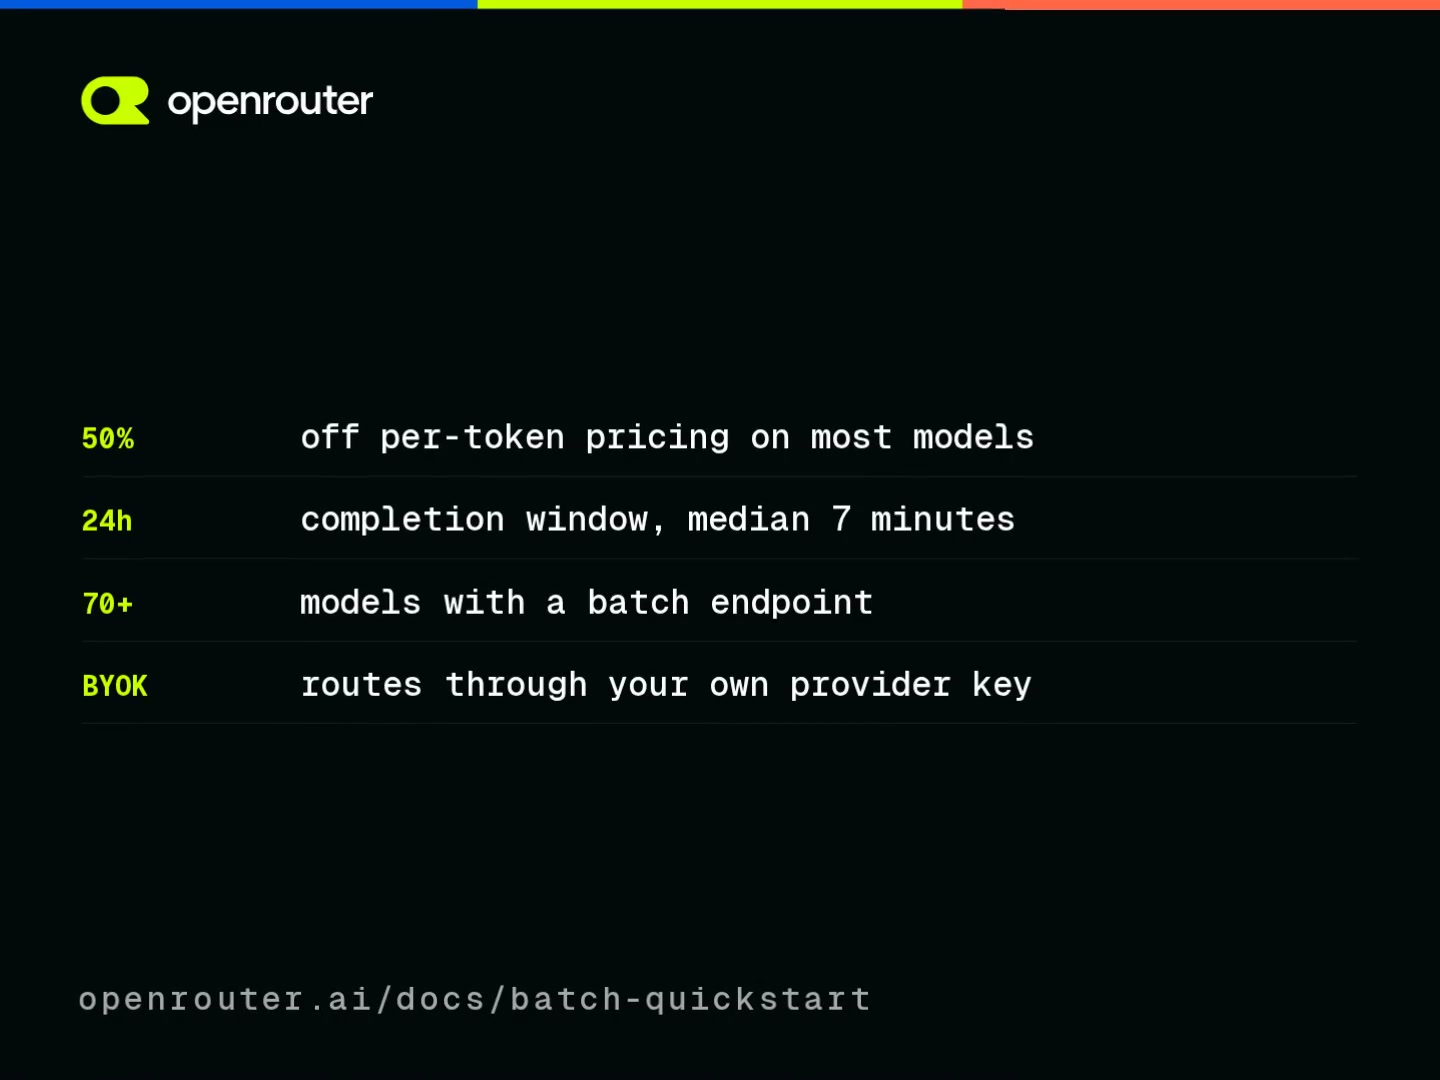
官方宣布Batch API上线,多数模型按Token半价计费,结果在24小时内返回。
OpenRouter 还上线了批处理 API。多数支持的模型按 Token 半价计费,结果在二十四小时内返回。文档批量分析、离线标注和夜间评测,可以把响应速度换成更低成本。实际使用时,按各模型支持情况提交批次,适合把实时交互和后台任务分开安排。
批处理适合离线标注、批量分析和夜间评测。提交前需要核对目标模型的支持情况、输入格式、数据保留和插件要求,多数支持模型的半价策略与实时请求分别计算。
原始来源:OpenRouter ↗
09 / 本地AI
Transformers 直接运行 GGUF
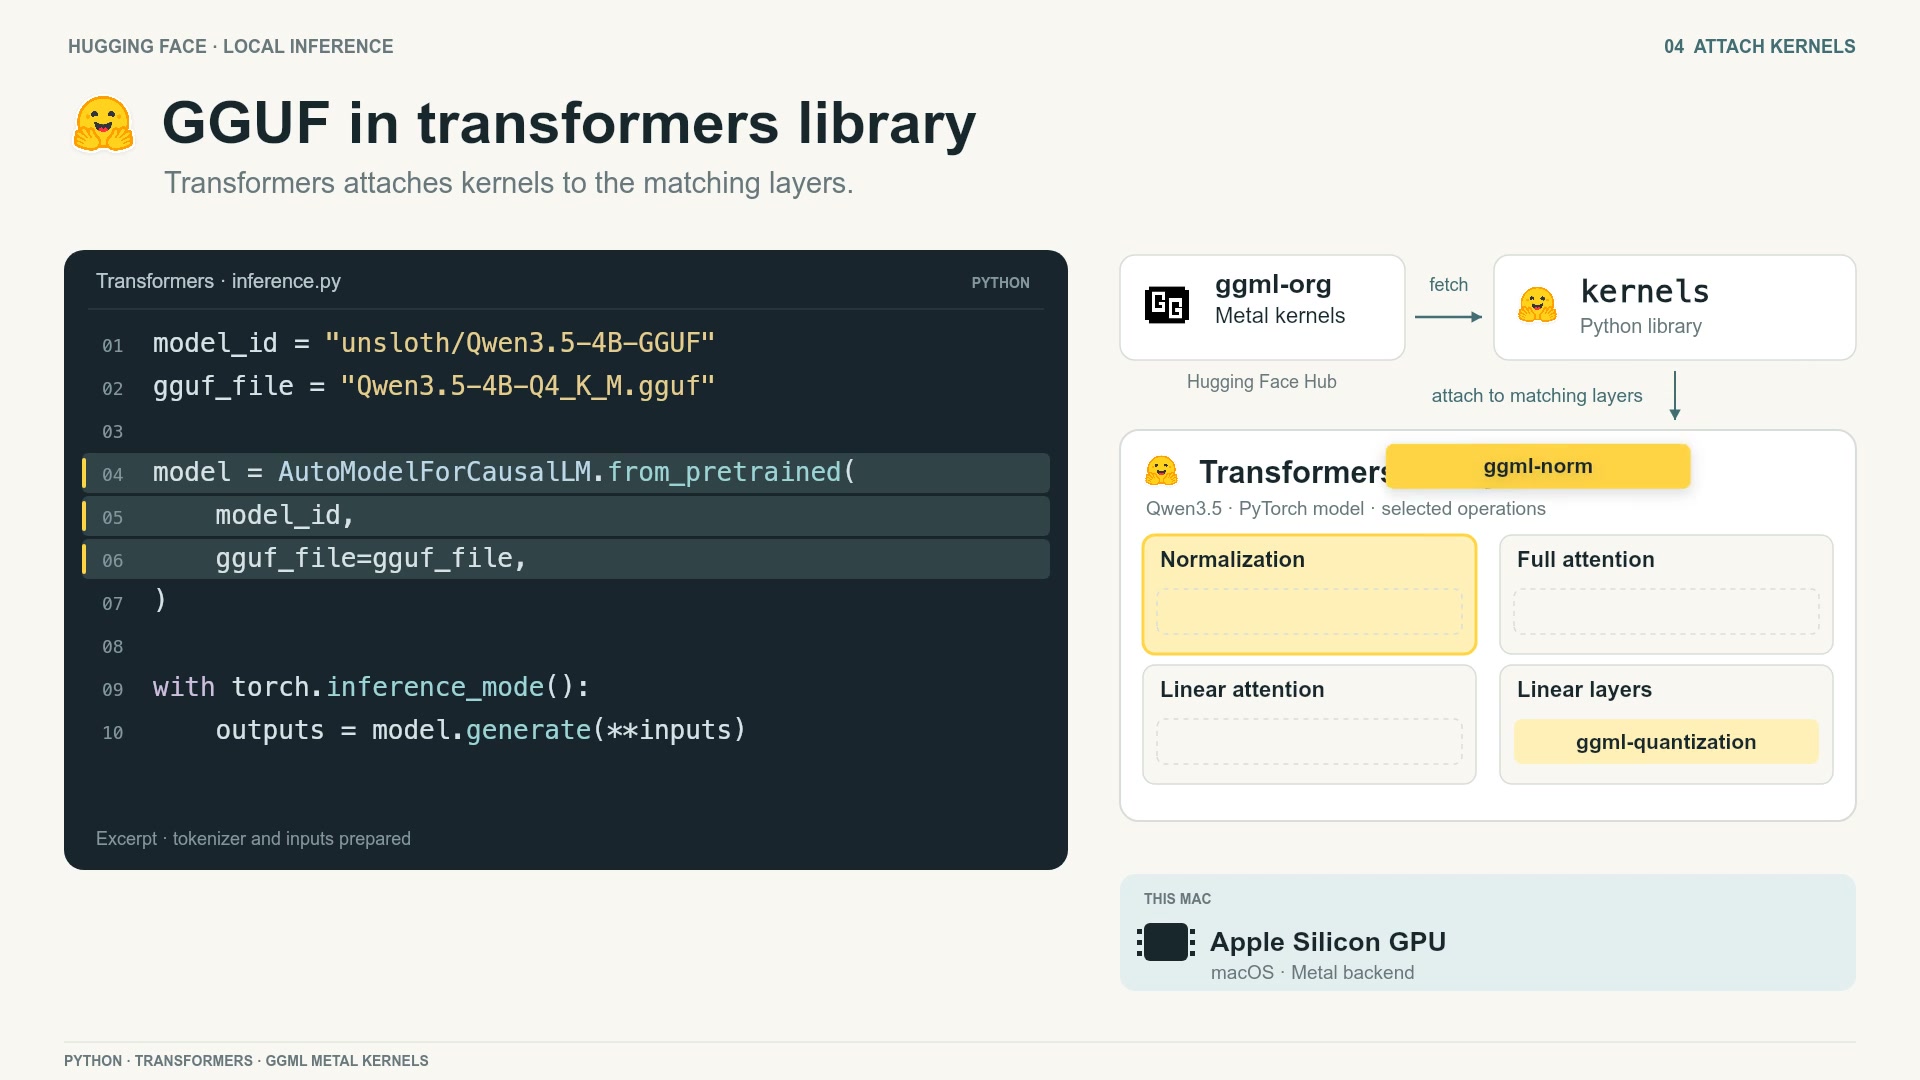
Hugging Face介绍通过Transformers接口高效加载GGUF,并复用ggml算子,面向笔记本本地推理。
本地推理也有新入口。Hugging Face 介绍了 Transformers 对 llama.cpp 的 GGUF 量化模型的直接运行支持,加载模型后可复用 ggml 算子。开发者能在熟悉的 Transformers 接口里尝试笔记本推理。官方示例展示了加载和运行路径,具体模型架构与设备仍按兼容范围选择。
官方示例覆盖 GGUF 的加载与运行路径,并复用 ggml 算子。实际接入仍需按支持的模型架构、设备与运行环境测试兼容性。
原始来源:Hugging Face ↗
10 / 机器人开发
Isaac ROS 5.0 发布
新版本在ROSCon发布,增加智能体开发工作流,并支持ROS Lyrical与Ubuntu 24.04等平台。
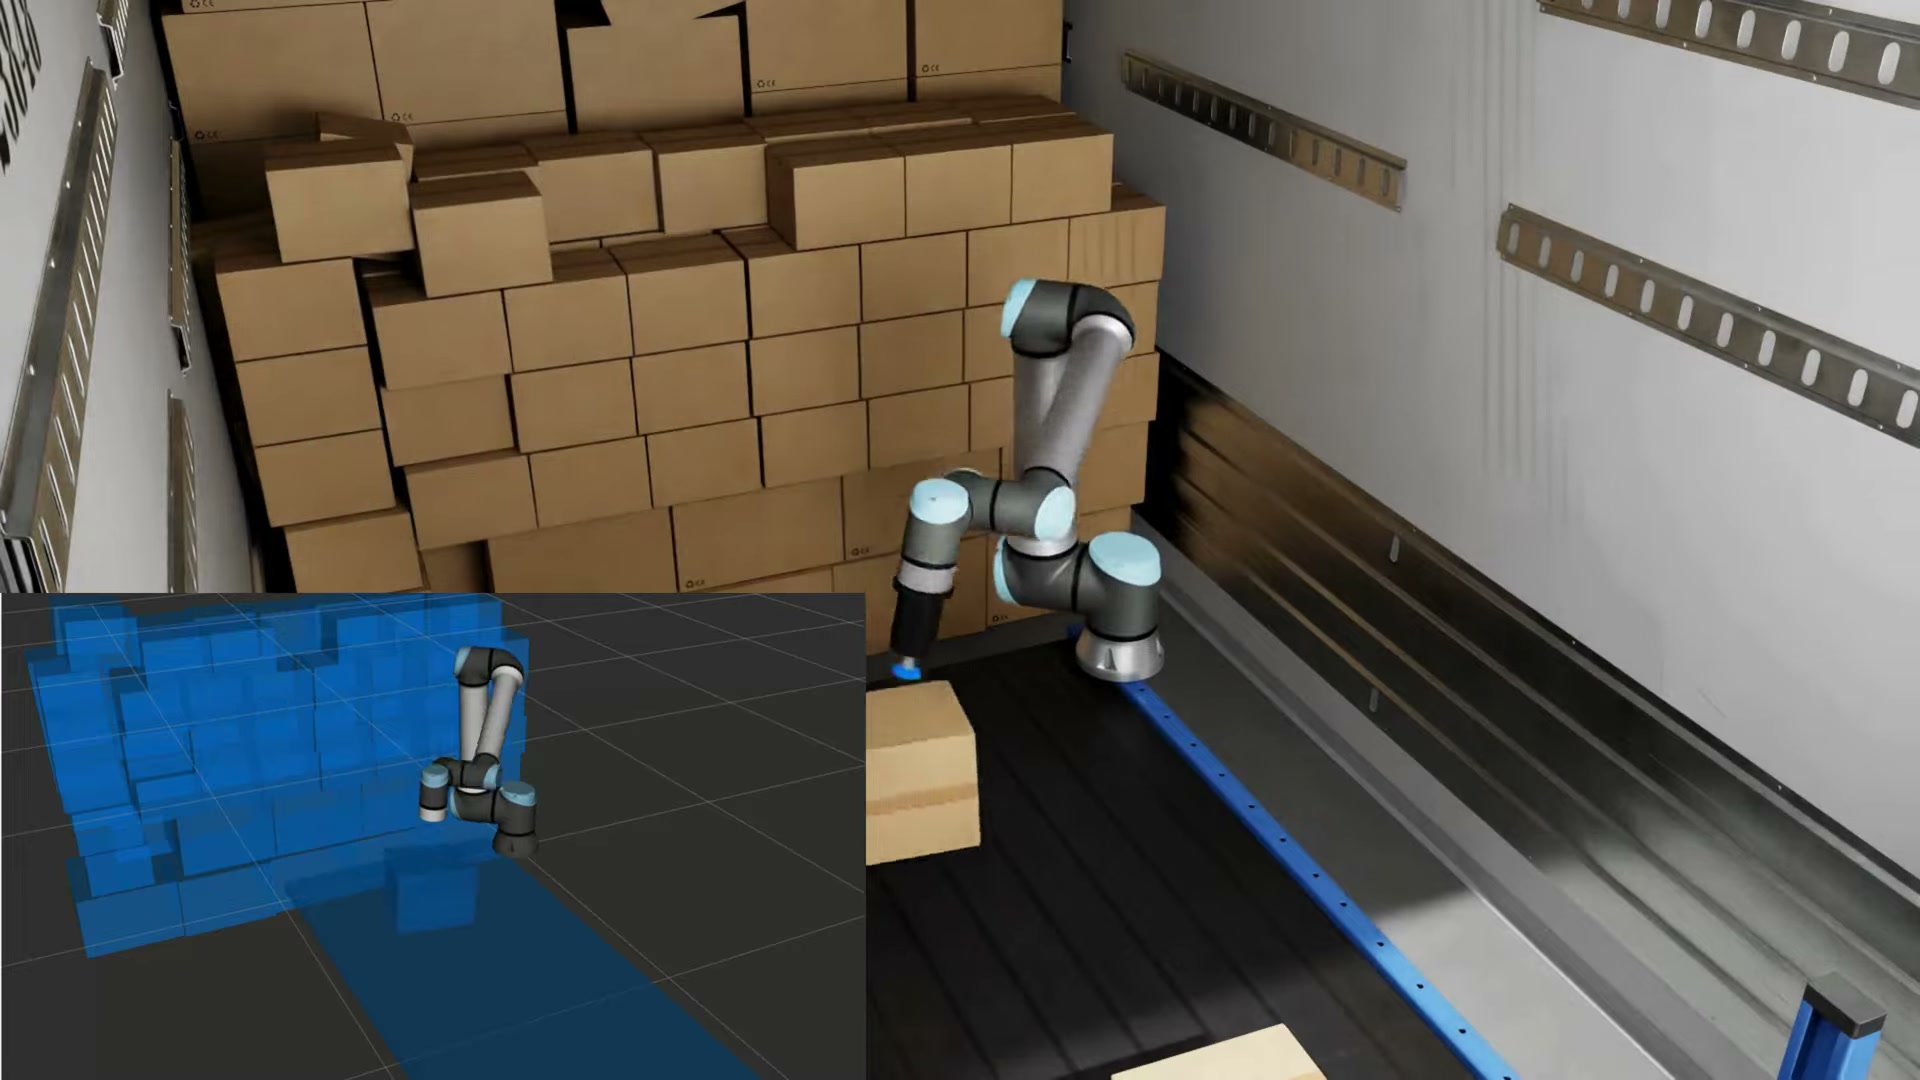
从软件走向机器人,NVIDIA 在 ROSCon 发布 Isaac ROS 5.0,把智能体工作流加入机器人开发,并支持 ROS Lyrical 和 Ubuntu 二十四点零四等平台。官方展示了机械臂路径规划和搬运场景,配套工具面向 Jetson 等硬件部署。团队可以用这些组件搭建流程,再在目标机器人上验证感知与动作表现。
官方演示包括机械臂路径规划和搬运,相关组件面向 Jetson 等机器人硬件部署。开发团队可据此搭建感知与动作流程,再在目标设备验证实时表现。
原始来源:NVIDIA ↗
11 / 智能体应用
车内 Grok 增加任务能力
Tesla官方展示Grok Bot处理咖啡订单、餐厅预订和预约安排等更复杂任务。
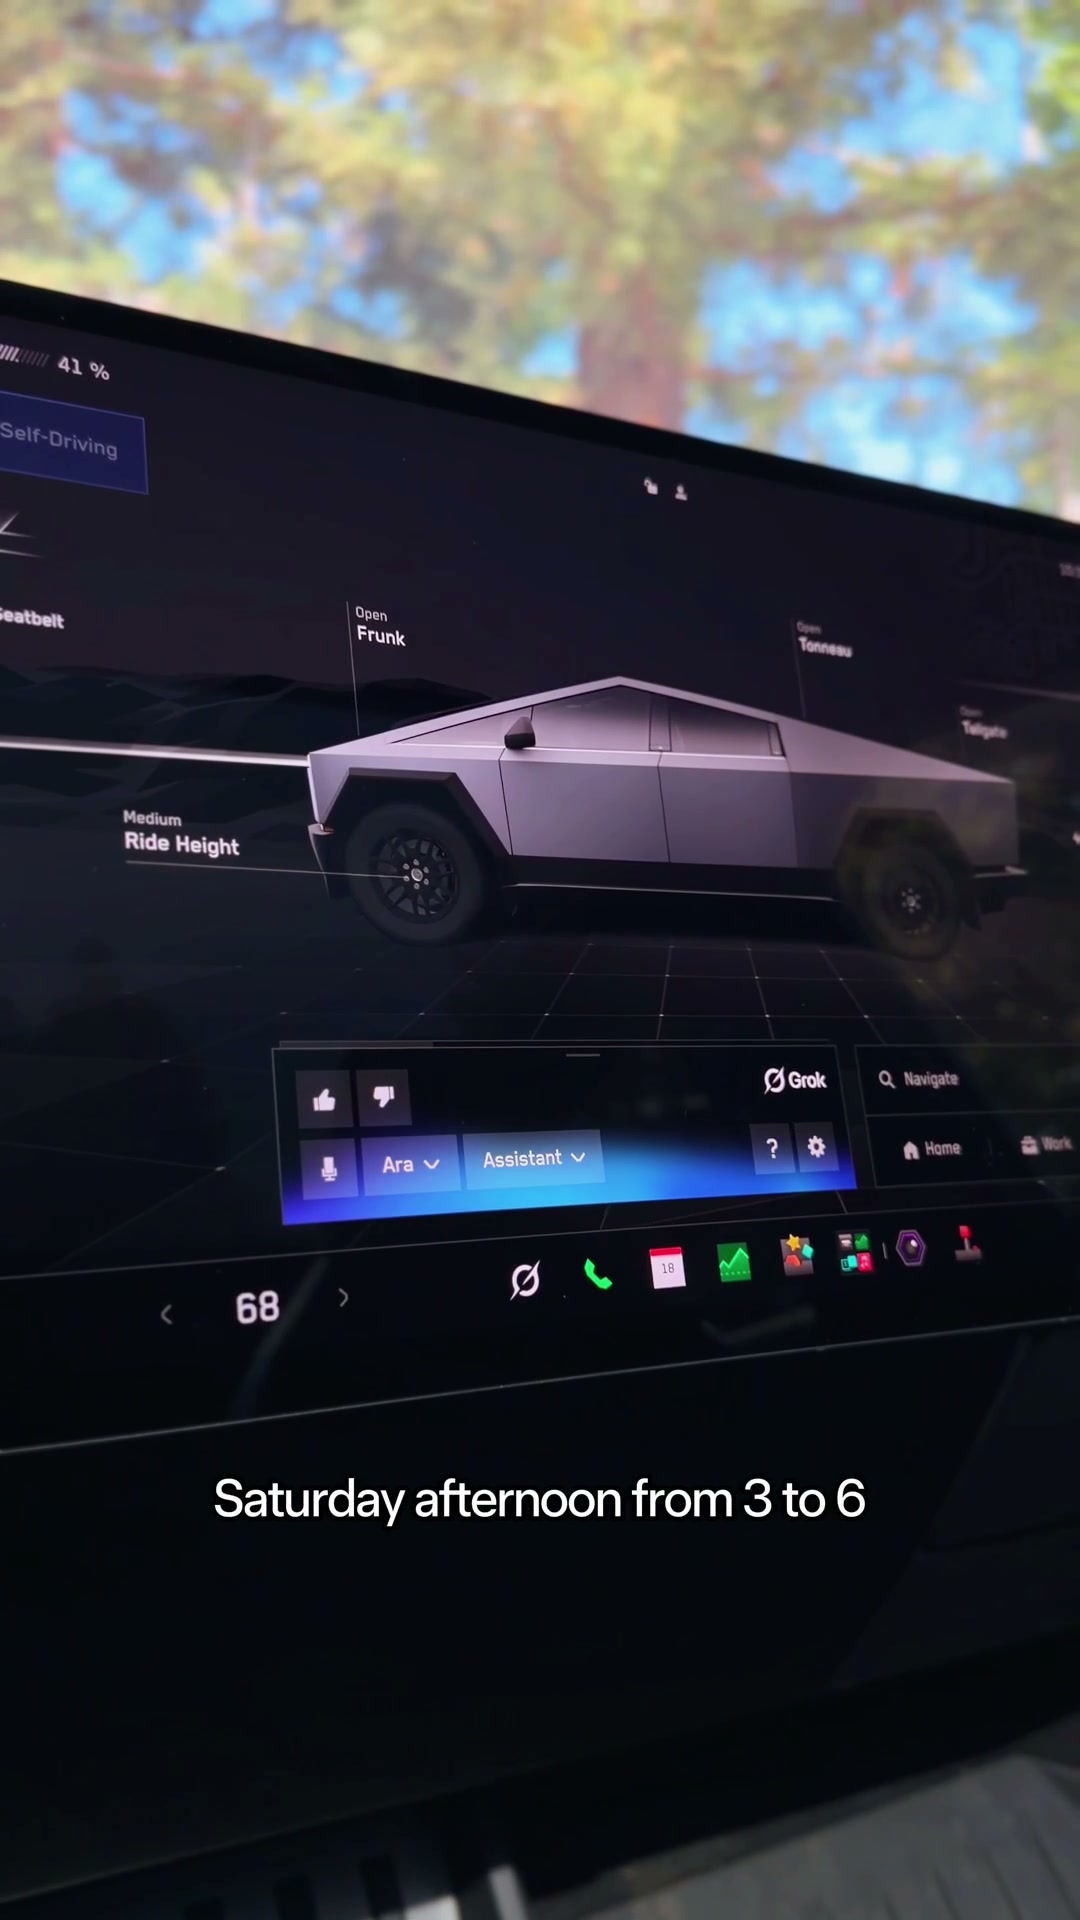
Tesla 官方展示了车内 Grok 的新任务能力。连接已有服务后,可以通过语音处理邮件、日历以及文件等事务。同一公告线程还介绍 Grok Bot 能处理咖啡订单、餐厅预订和预约安排,这部分复杂任务目前面向 SuperGrok Heavy 订阅者,其他档位后续开放。画面展示的是 Tesla 官方实车演示。
官方线程分别展示车内连接器工作流与 Grok Bot 的复杂任务。咖啡订单、餐厅预订和预约安排目前面向 SuperGrok Heavy,其他档位计划后续开放;车型与地区按实际版本供应。
原始来源:Tesla ↗
国内新闻
12 / 视频生成
Seedance 2.5 样片模式
火山引擎官方介绍Draft模式:先生成480P样片,再通过样片ID生成1080P终版;即梦也提供样片模式入口。
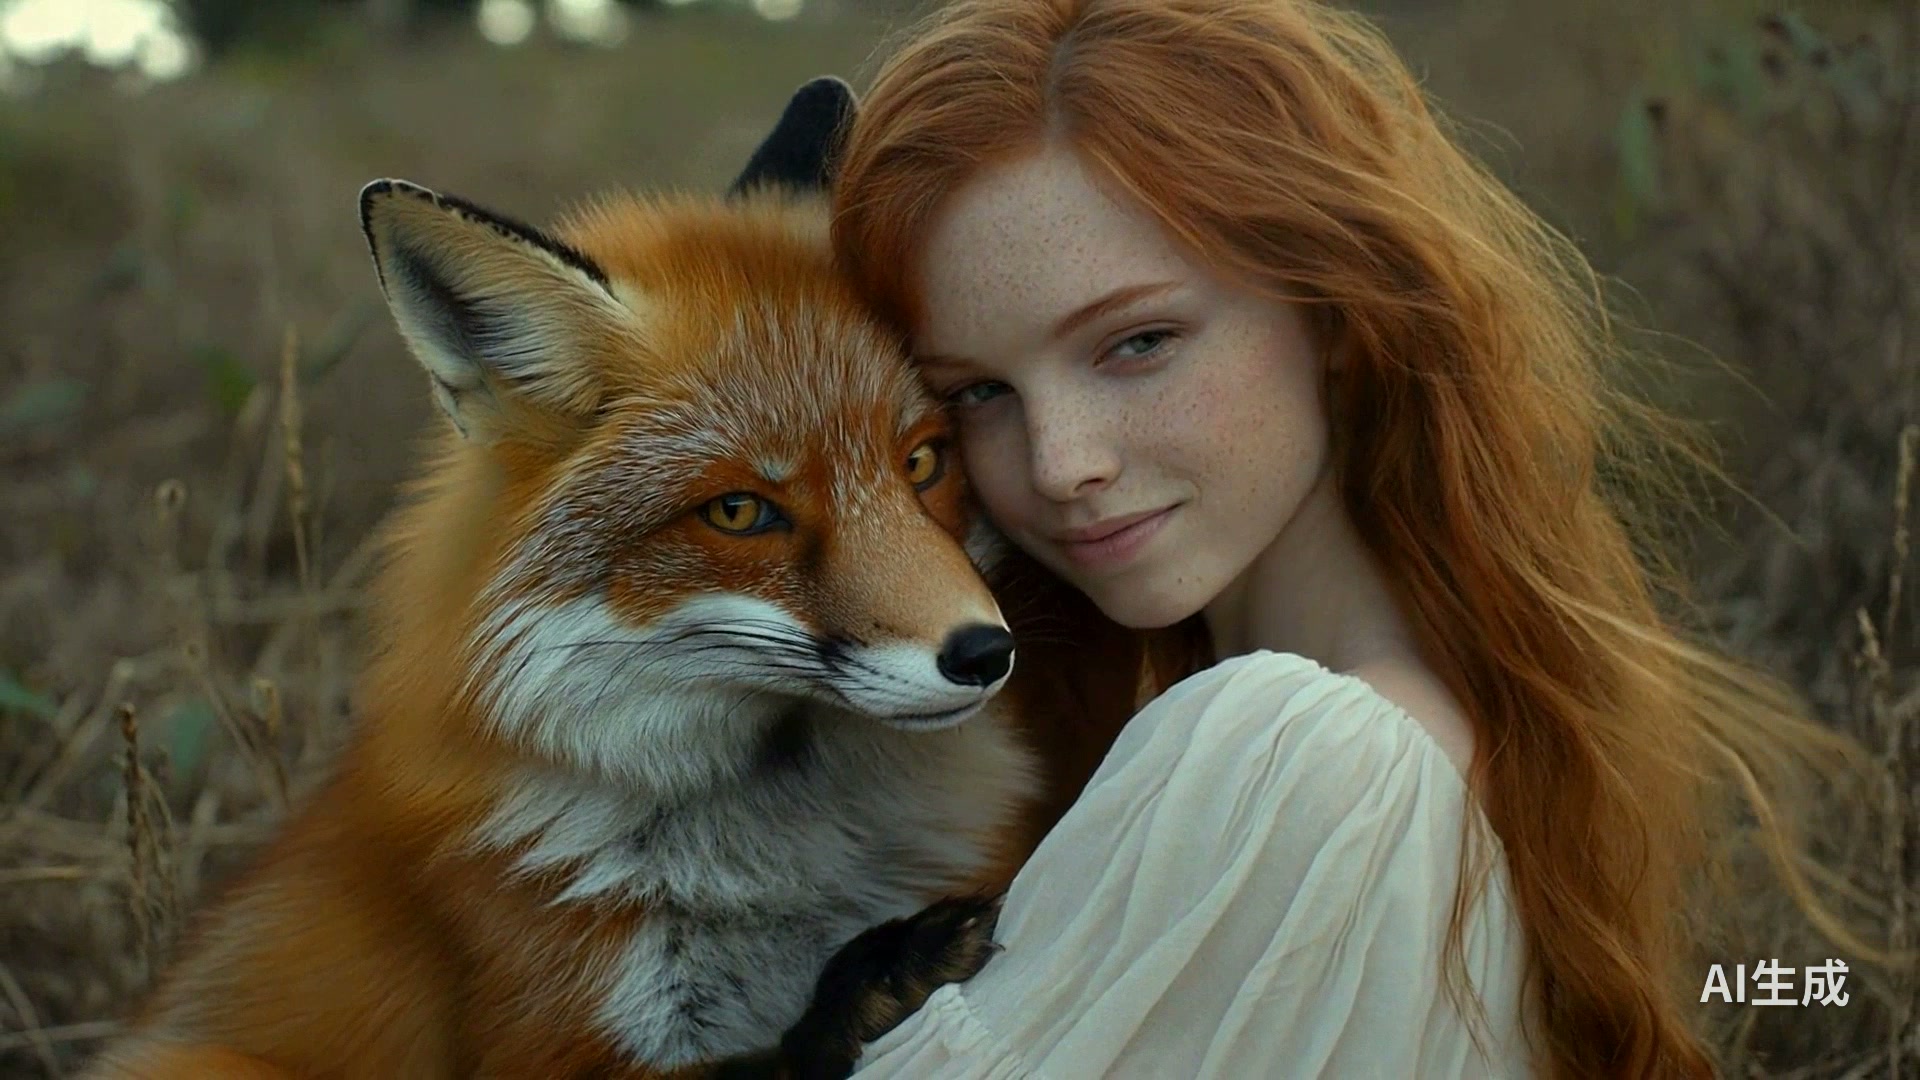
国内创作工具这边,Seedance 2.5 上线 Draft 样片模式。先生成四百八十 P 样片,检查镜头、动作和创意,再用样片任务 ID 生成一千零八十 P 终版。系统会复用提示词、素材和种子等关键参数。终版仍会重新推理,局部纹理和小字可能变化。对需要反复挑选镜头的创作者,这提供了成本更低的前期验证步骤。
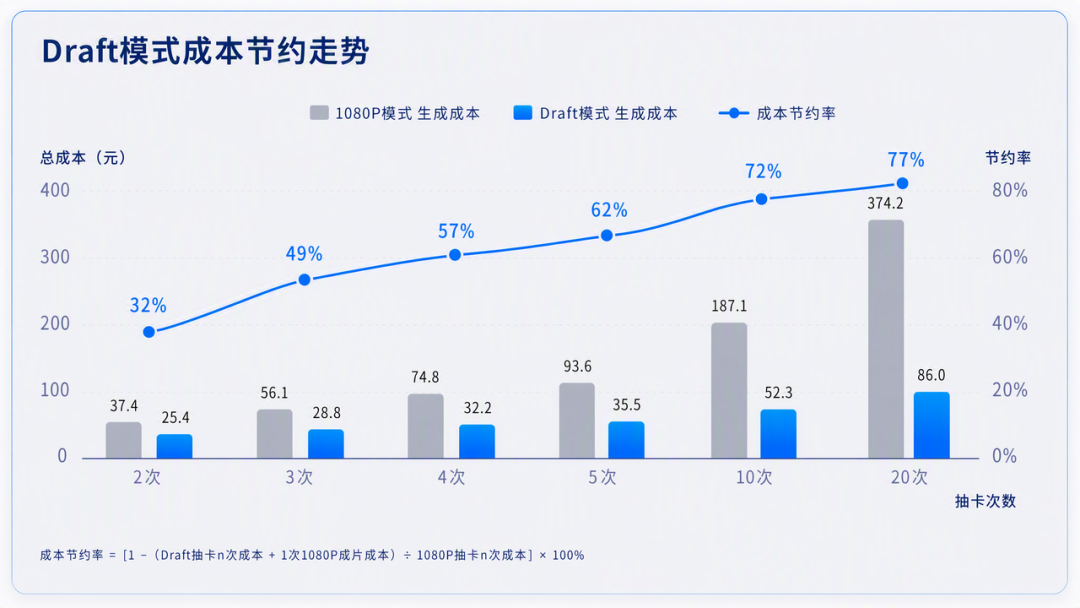
官方示例对照了 480P 样片与 1080P 终版。终版会再次推理,局部纹理、小字和复杂人群可能变化;文中的节约 57% 对应一个 5 秒镜头尝试 4 次的示例。
原始来源:火山引擎 ↗
13 / 图像生成
混元图像 3.5 预览版
Hy Image3.5 preview支持最多5张参考图、最高2K和多轮编辑;元宝、WorkBuddy等产品接入,腾讯云API按输出图片收费。
腾讯发布混元图像三点五预览版,支持最多五张参考图、最高二 K 输出和多轮编辑。官方样例展示了中文信息图、多素材组合,以及服装等局部修改。元宝、WorkBuddy 等产品接入,腾讯云 API 按输出图片计费,每张零点一五元;部分应用提供限期体验,具体权益与 API 计费分别执行。
官方样例展示中文信息图、多张素材组合与局部服装编辑。最多 5 张参考图和最高 2K 输出属于本次预览版能力;部分应用限期体验与腾讯云按张计费分别执行。
原始来源:腾讯混元 ↗
14 / 模型进展
Qwen 4 已进入训练
阿里确认Qwen 4正在训练,Qwen 4.5与Qwen 5规划扩展至5万亿—10万亿参数;介绍Qwen3.8-Max自主迭代实验。
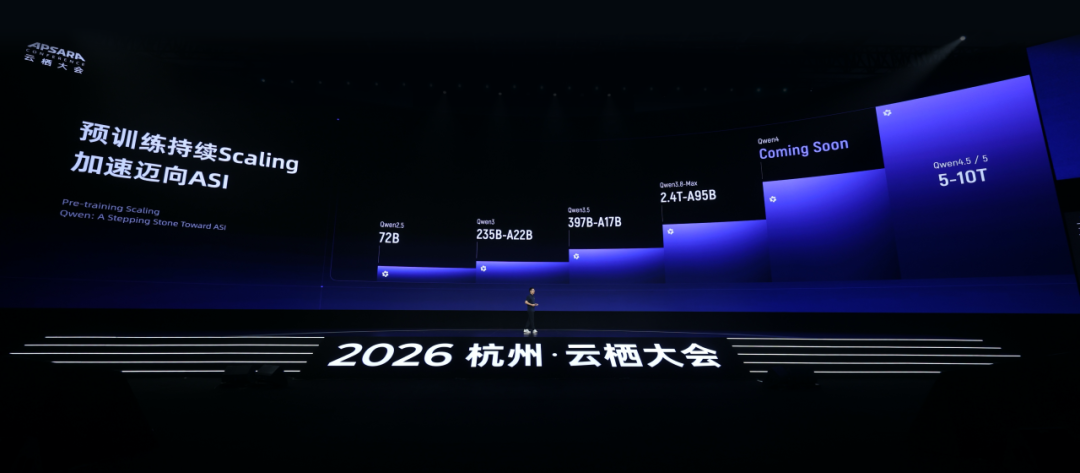
云栖大会公布了阿里的下一步模型路线。Qwen 四正在训练,后续 Qwen 四点五和五系列规划扩展到五万亿至十万亿参数。阿里还介绍了 Qwen 三点八 Max 在预设工具和反馈环境中的自主迭代实验。这一条的重点是训练进展和未来规划,后续模型的实际开放时间仍待发布。
此次信息涵盖正在训练的 Qwen 4、后续参数规模路线图和 Qwen3.8-Max 的自主迭代实验。实验采用人工预设工具与验收反馈,后续模型的实际开放时间仍待公布。
原始来源:阿里巴巴 / 阿里云 ↗
15 / 开源模型
Ming 开源图像设计模型
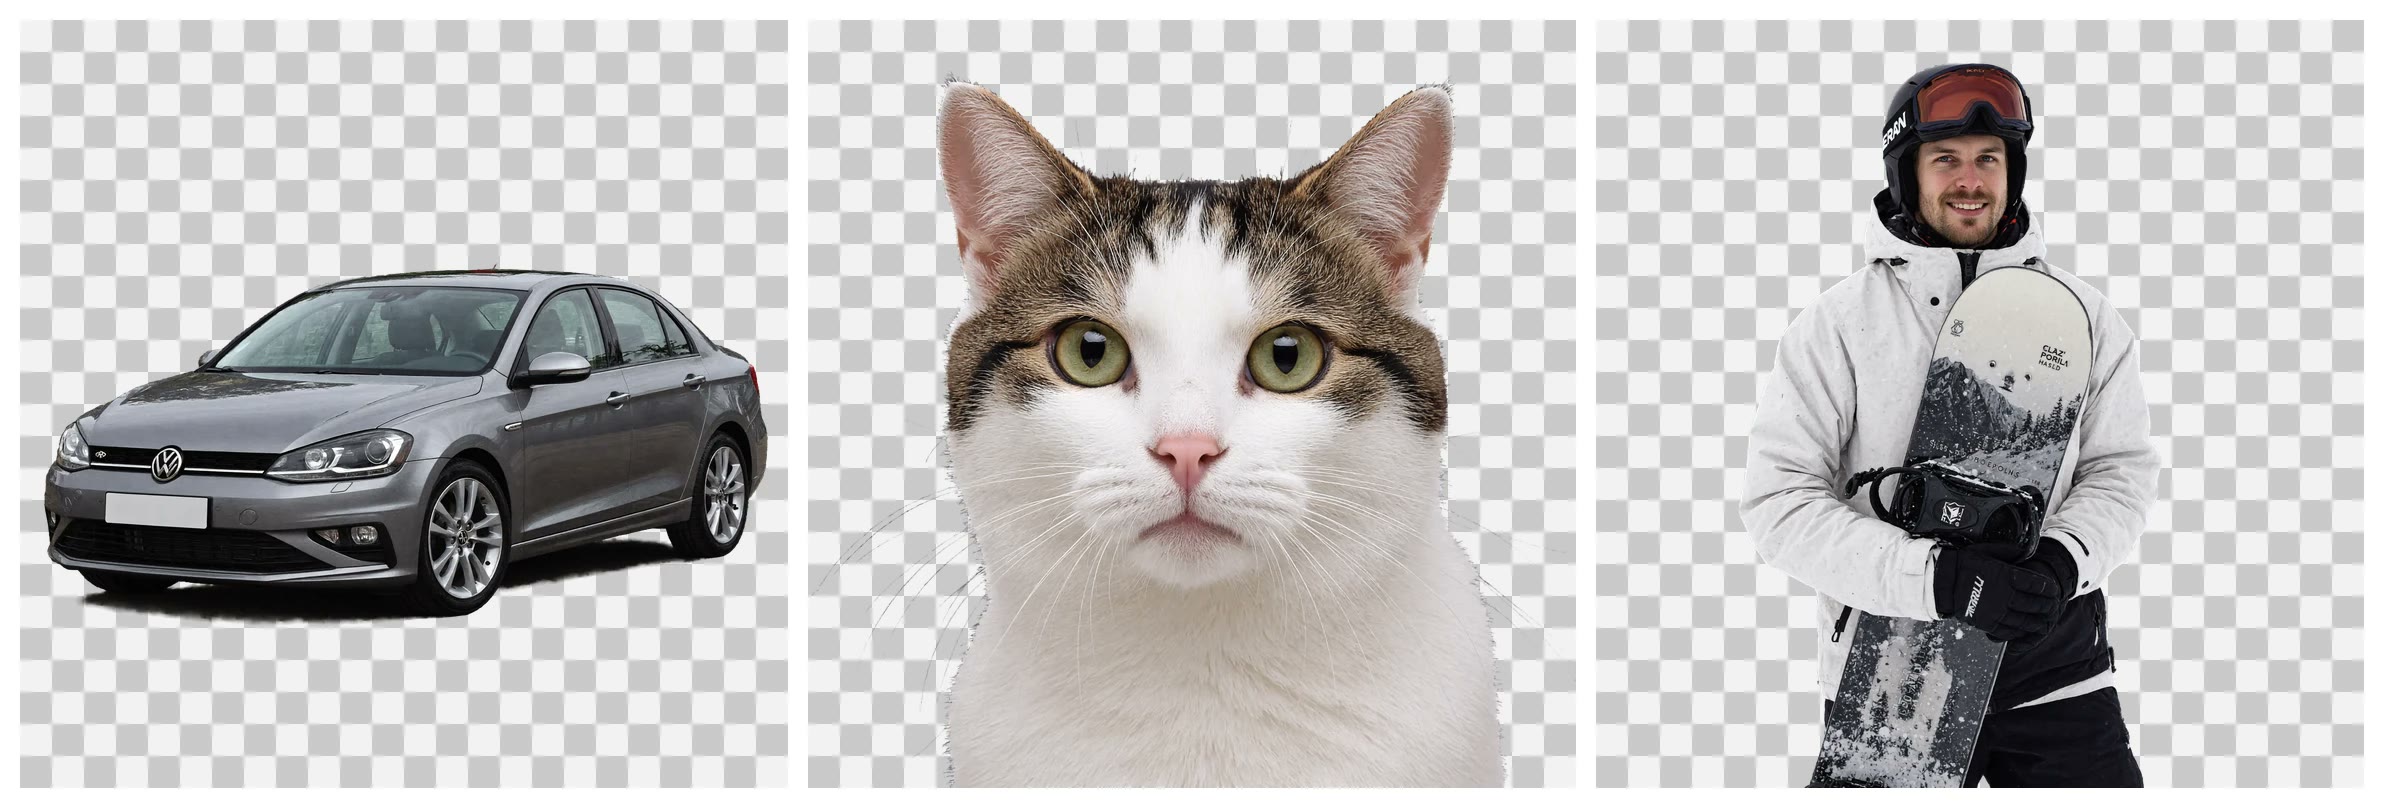
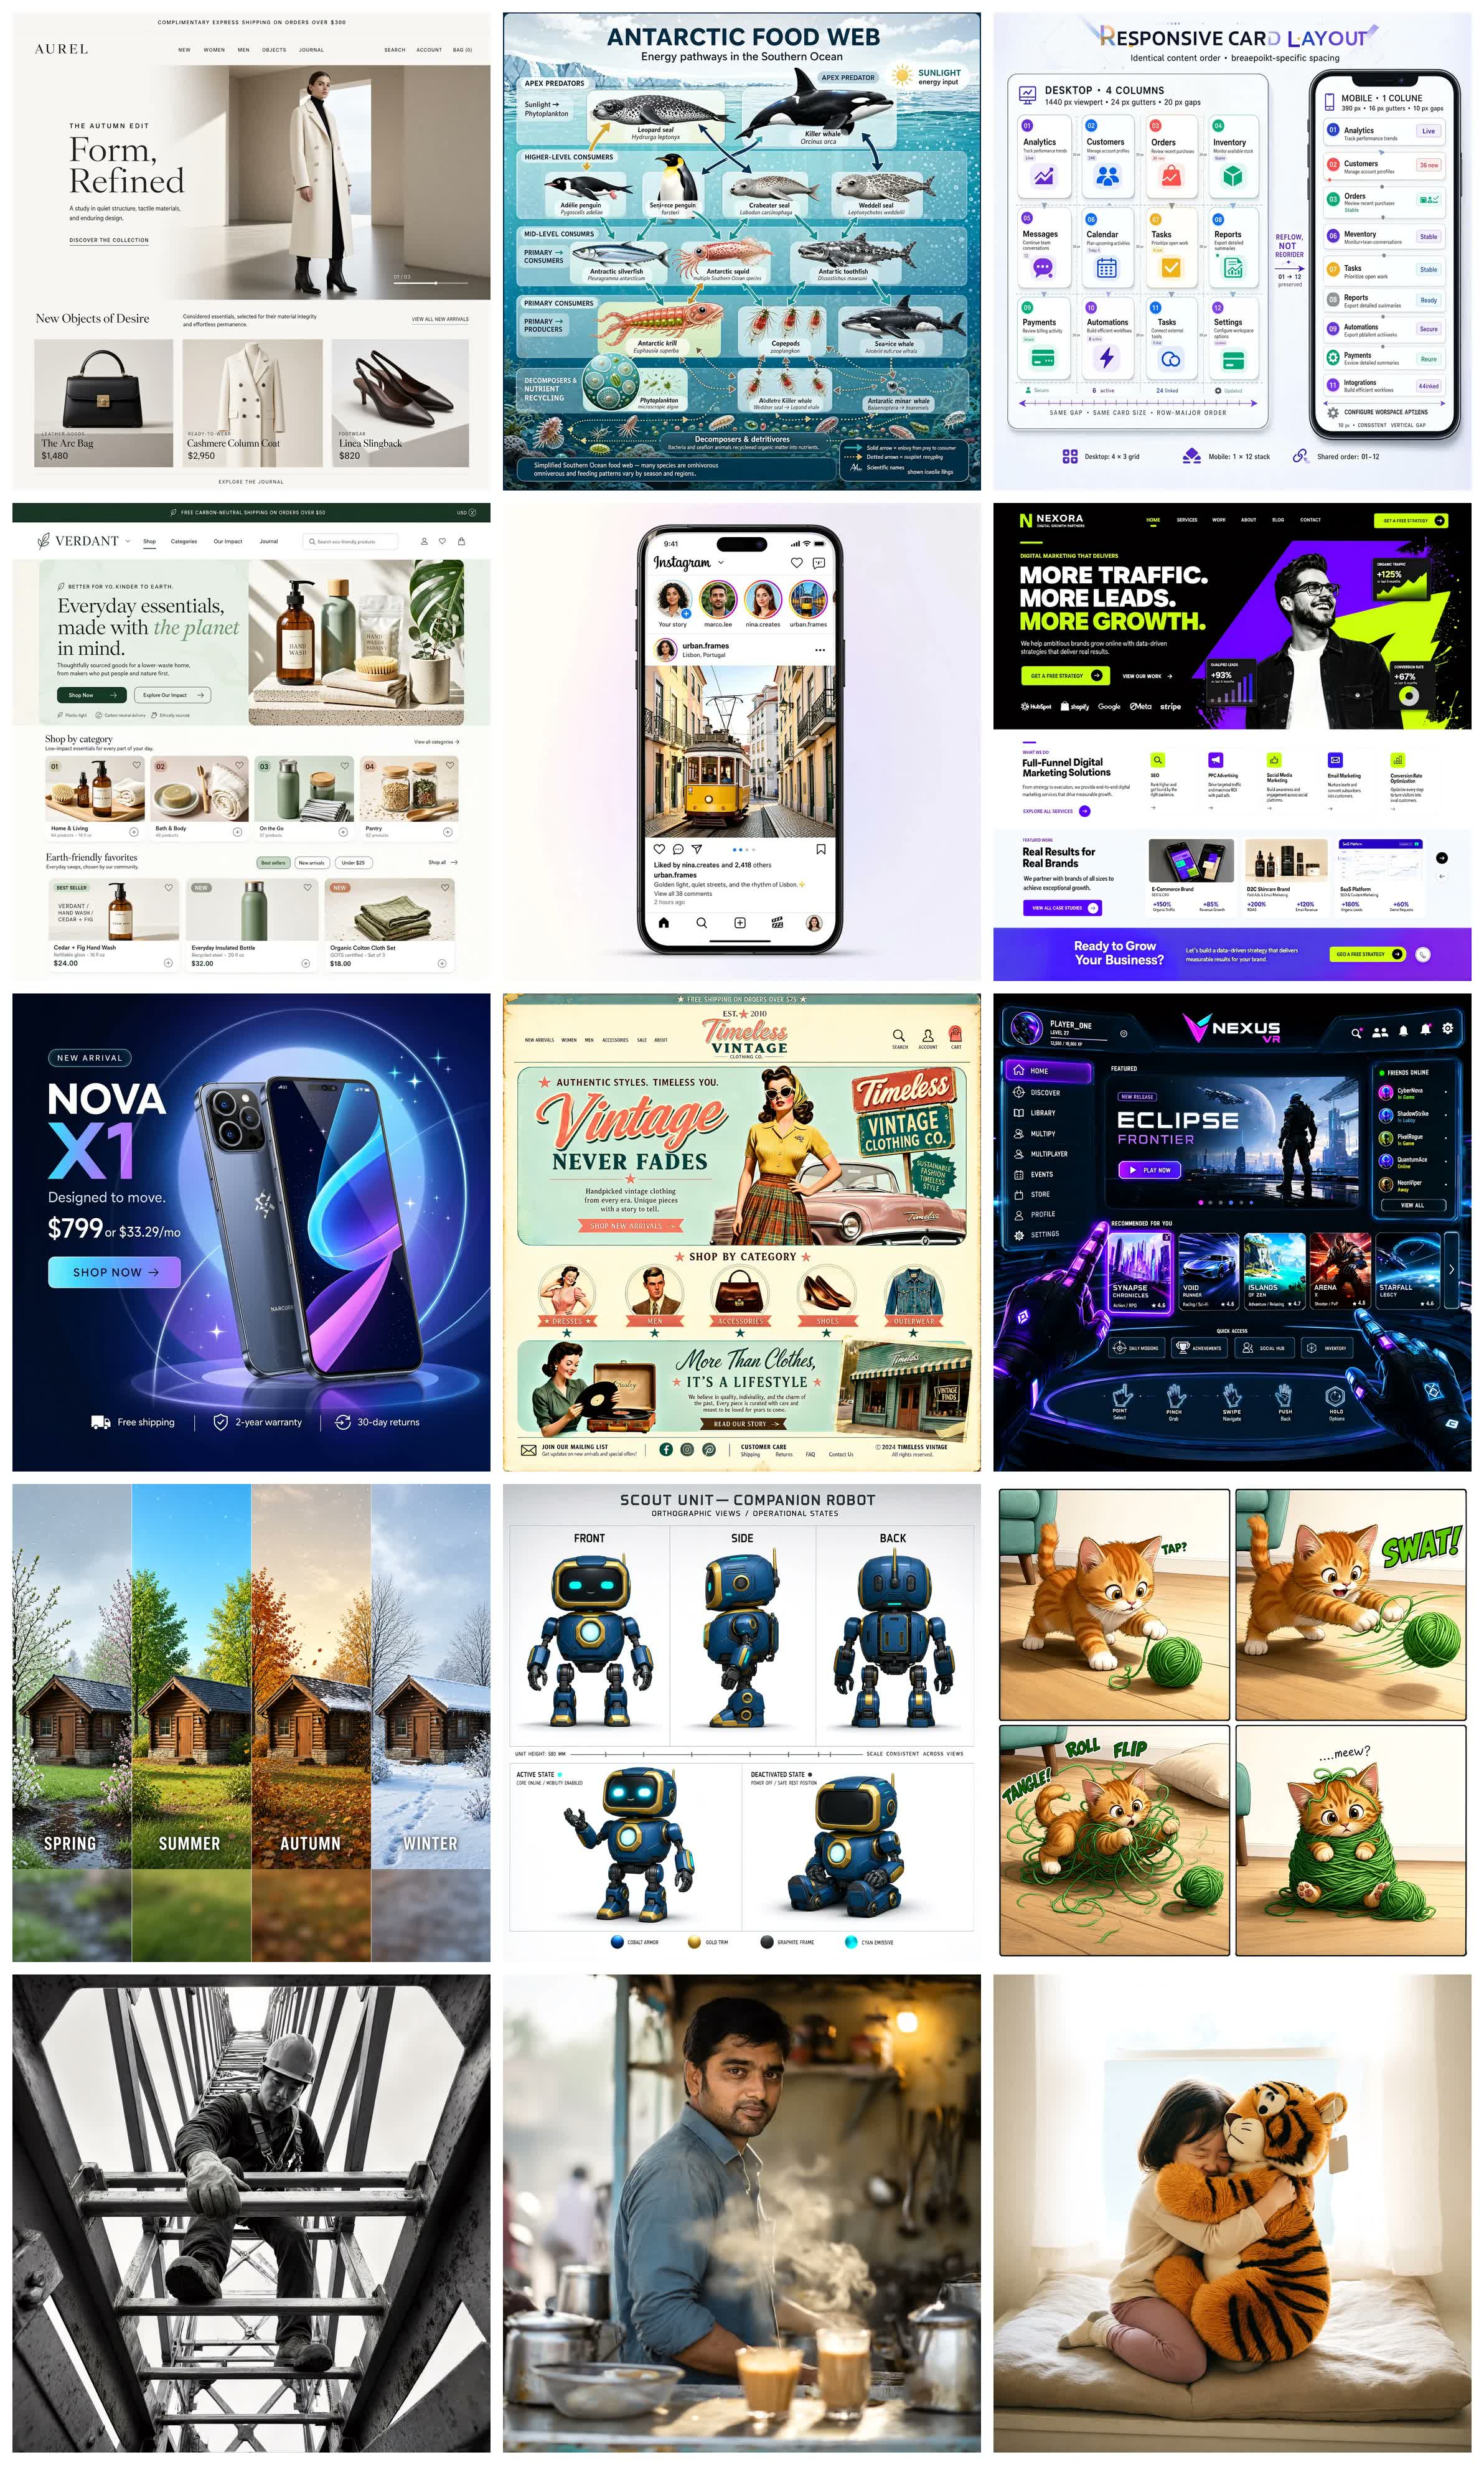
Ming-Image-0.1-Design系列含两个6B模型及UI设计、图片转可编辑PPT技能;主模型支持RGBA透明背景并采用MIT许可证。
蚂蚁开源 Ming 图像设计模型系列,包含两个六 B 模型,以及界面设计、图片转可编辑 PPT 等配套技能。主模型支持带透明通道的 RGBA 图像,并采用 MIT 许可证。对设计流程来说,可以进一步衔接素材生成和后续编辑。官方验证配置使用八十 GiB 显存的 CUDA 显卡,部署时要按实际资源要求评估。
主模型的 RGBA 输出面向透明素材,配套设计技能衔接界面与演示文档工作流。官方验证使用 80 GiB 显存 CUDA 显卡,本地部署需先核对显存与依赖要求。
原始来源:蚂蚁 inclusionAI ↗
16 / 智能体工具
Kimi 浏览器扩展更新
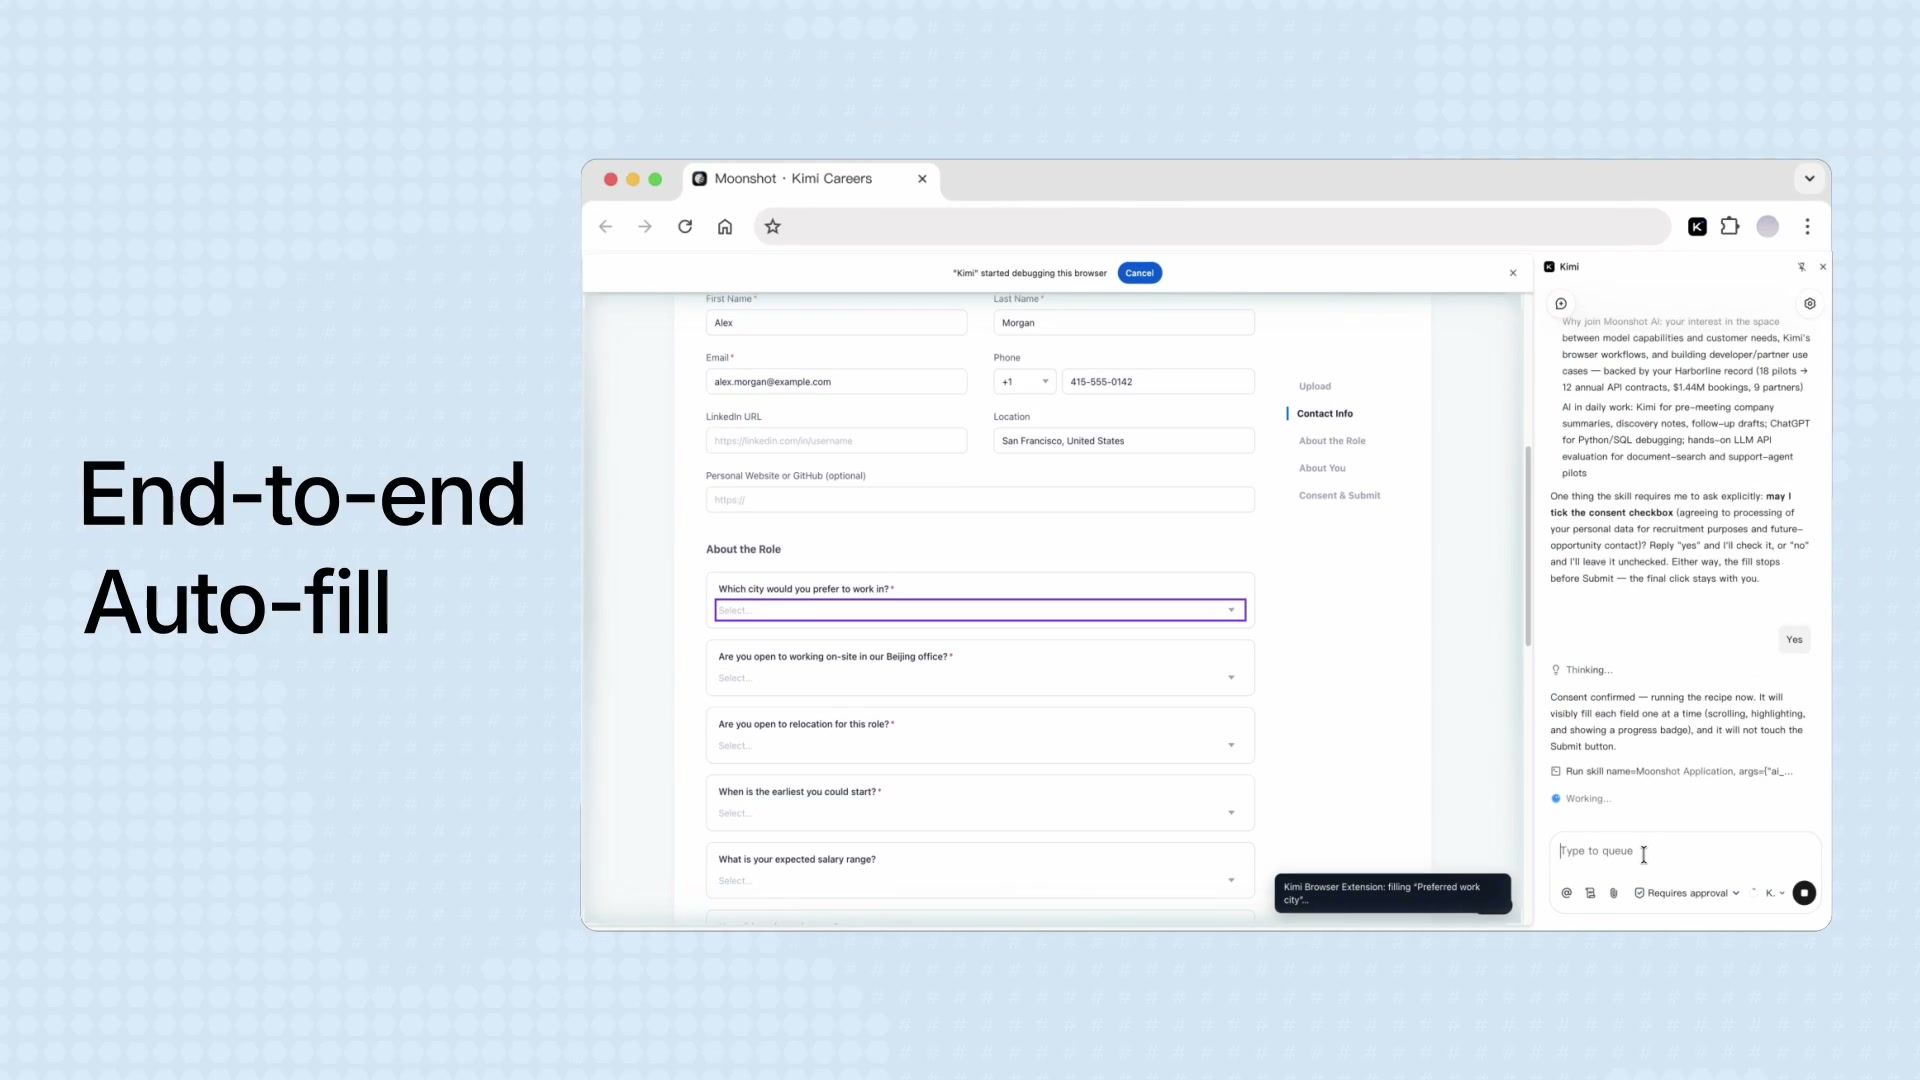
原Kimi WebBridge更名为Kimi Browser Extension,可在侧栏对话导航网页、填表,并把重复步骤记录为技能。
Kimi 把 WebBridge 更名为浏览器扩展,并更新了工作方式。用户可以在侧栏对话,让它导航网页、填写表格,还能把重复操作记录成可复用技能。官方演示展示了从页面读取信息到自动填表的过程,Chrome 商店和官网已提供入口,具体网站的兼容性仍需实际使用验证。
这次升级将侧栏对话、网页导航、表单填写和可复用技能放入同一扩展。Chrome 商店与官网提供入口,实际网站兼容性及操作权限需要逐站核对。
原始来源:Kimi ↗
17 / AI芯片
真武 V900 公布
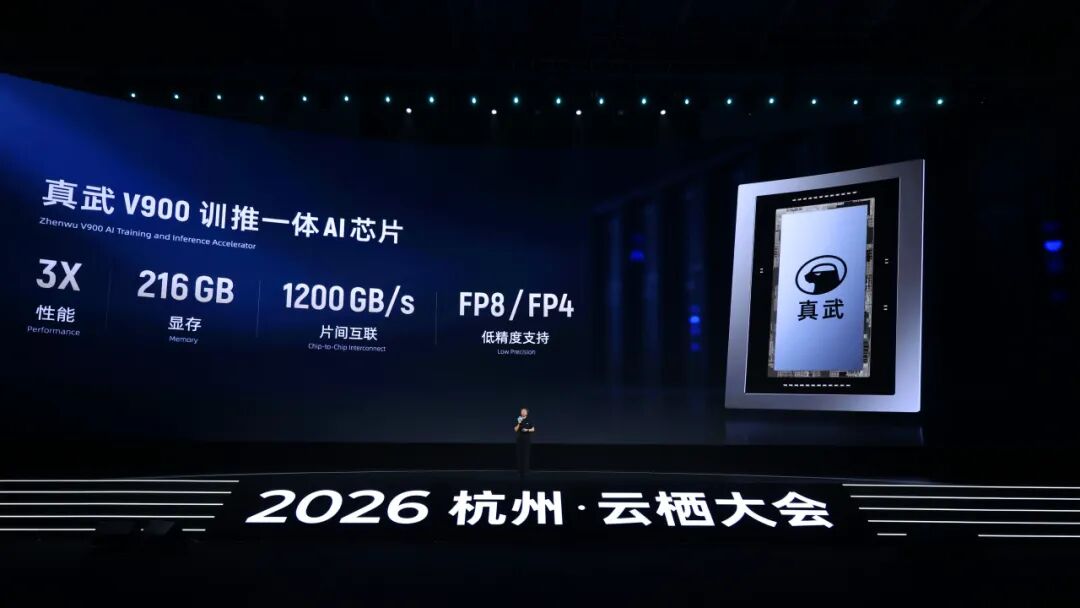
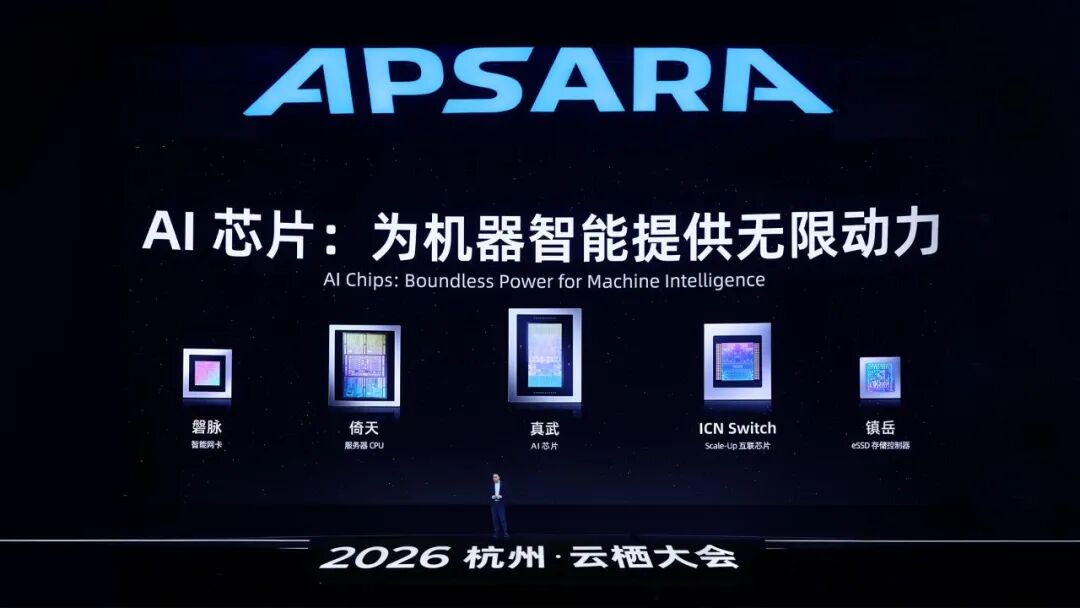
阿里公布训推一体V900,216GB显存与1200GB/s芯片间带宽,并给出下一代CPU路线。
硬件方面,平头哥公布训推一体芯片真武 V 九百,配备二百一十六 GB 显存,芯片间带宽为每秒一千二百 GB,并原生支持 FP 八和 FP 四。阿里称其性能达到前代 M 八九零的三倍,计划在二零二七年第一季度量产和商业发售。这是面向后续大规模训练与推理的硬件规划。
官方公布的主要参数包括 216 GB 显存、1200 GB/s 芯片间带宽,以及 FP8、FP4 支持。性能对比采用前代 M890,量产与商业发售计划为 2027 年第一季度。
原始来源:平头哥 / 阿里云 ↗
18 / 语音模型
Qwen 更新语音模型家族
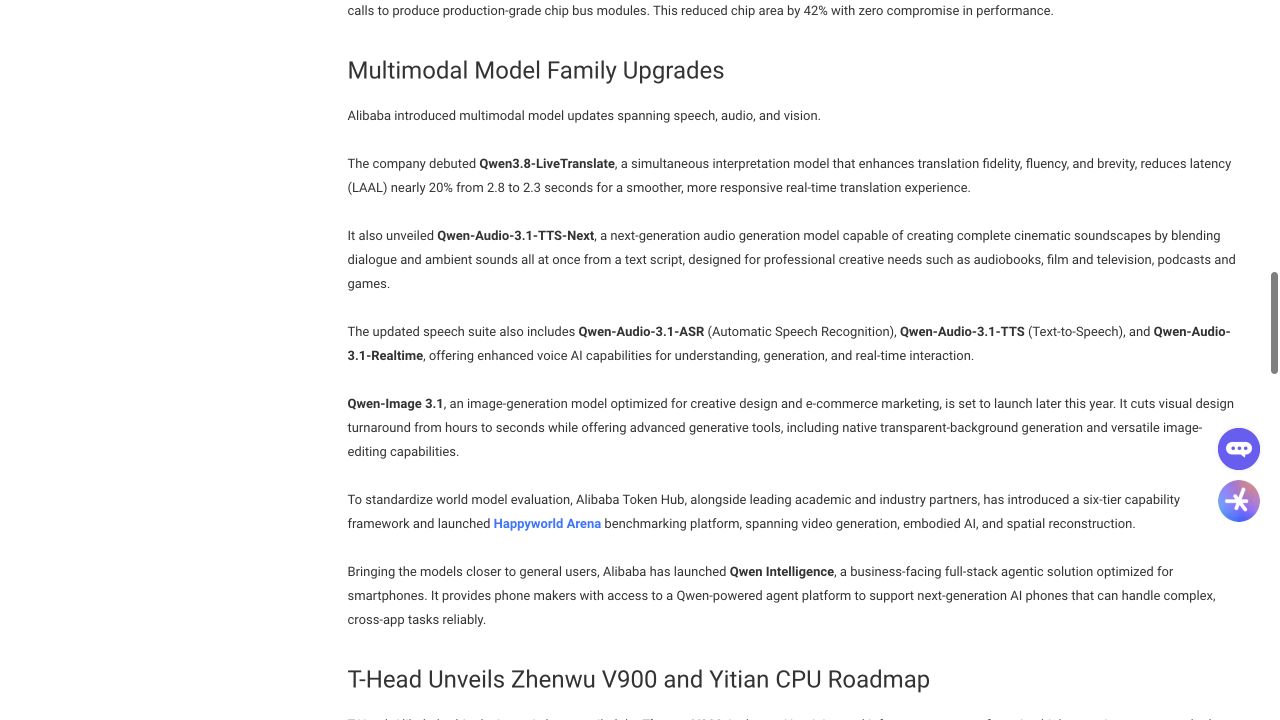
云栖公布Qwen-Audio-3.1系列及TTS-Next,后者面向对白和环境声一体生成;LiveTranslate改善实时翻译延迟。
阿里还更新了 Qwen Audio 三点一家族,涵盖语音识别、语音合成和实时交互。新展示的 TTS Next 可以根据文本脚本,把人物对白和环境声音一起生成,面向有声书、影视、播客和游戏等创作场景。此次总览披露了能力方向,各项功能的具体调用入口和开放范围按后续产品文档执行。
此次总览涉及语音识别、合成、实时交互与 LiveTranslate 的实时翻译延迟改进。TTS-Next 面向对白与环境声一体生成,各项 API 入口和开放范围以产品文档为准。
原始来源:阿里巴巴 / 阿里云 ↗
19 / 智能体应用
Qwen Intelligence 发布
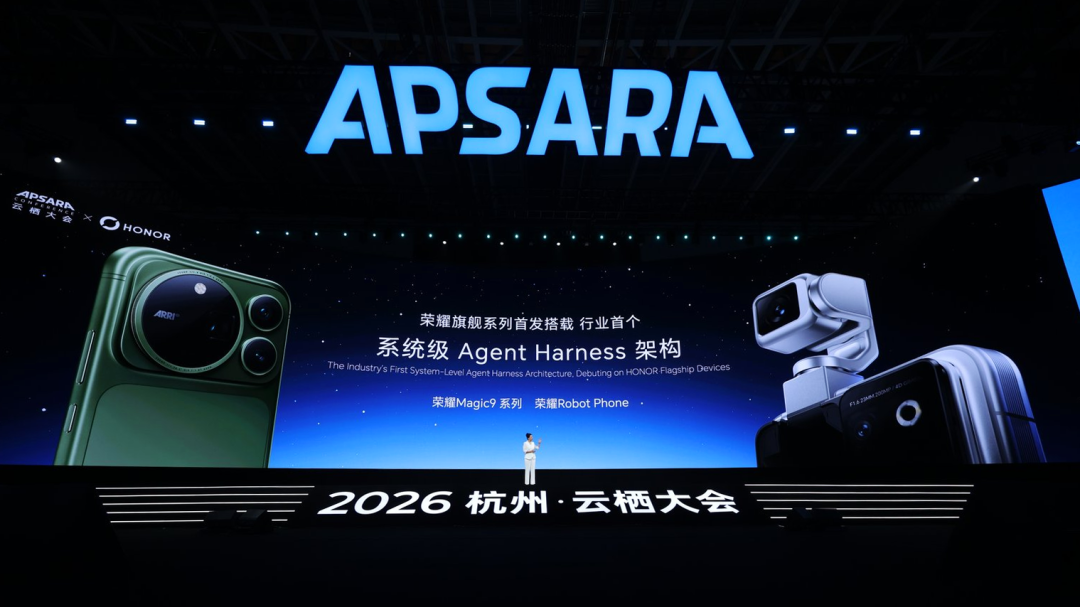
阿里面向手机厂商提供Qwen驱动的全栈Agent方案;官方称荣耀Magic9系列将成为首批搭载机型。
Qwen Intelligence 则把智能体能力带向手机。阿里面向手机厂商提供模型和全栈 Agent 方案,用于跨应用任务与系统级协作。官方披露,计划九月二十八日发布的荣耀 Magic 九系列将成为首批搭载机型。接下来可以重点观察真实手机上的跨应用执行,以及用户授权和操作确认如何落地。
方案面向手机厂商,把 Qwen 模型、Agent Harness 与系统协作连接起来。官方披露荣耀 Magic9 系列为首批搭载机型,计划于 9 月 28 日发布。
原始来源:阿里巴巴 / 阿里云 ↗
20 / 研究与工程
Qwen 披露芯片相关实验
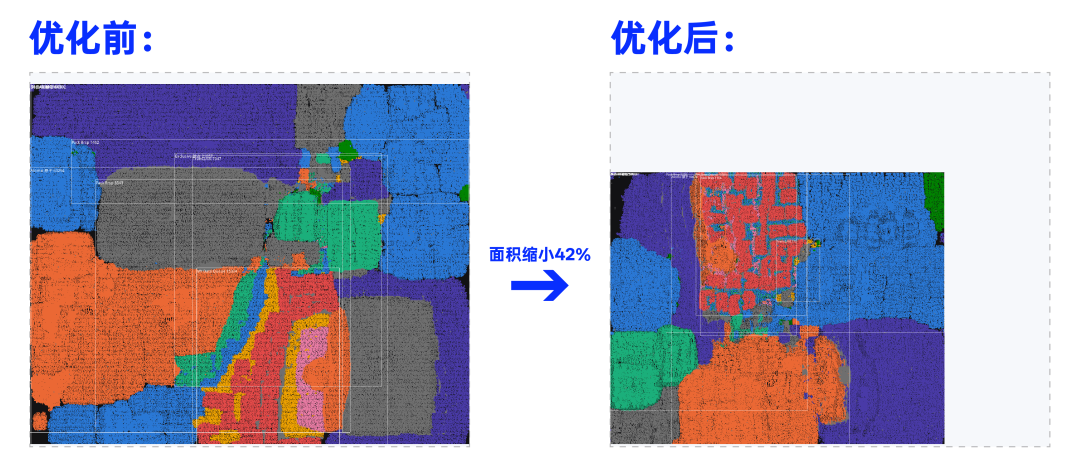
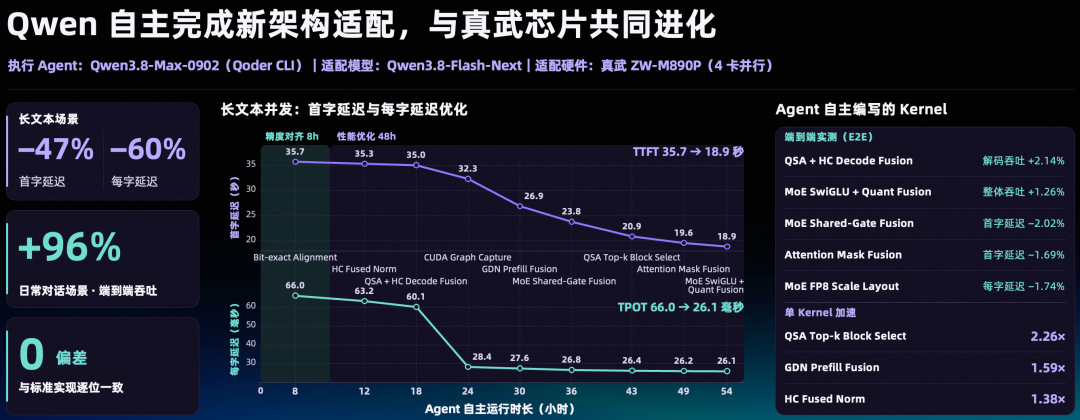
Qwen3.8-Max在预置EDA环境完成NoC模块设计优化;另一项实验在真武M890上优化Qwen3.8-Flash-Next推理。
另一个值得看的方向,是让模型参与芯片工程。通义披露,Qwen 三点八 Max 在预置 EDA 环境里优化 NoC 模块,特定实验中面积下降百分之四十二。另一项实验则在真武 M 八九零上优化 Qwen 三点八 Flash Next 推理,吞吐提高百分之九十六。两组结果分别对应芯片设计和软件适配,采用各自的测试基线。
NoC 实验的面积下降 42% 与 M890 推理实验的吞吐提升 96%,分别来自不同任务和测试基线。前者涉及设计优化,后者涉及模型在目标芯片上的软件适配。
原始来源:通义千问 ↗
21 / 智能体基础设施
阿里云推出 AgentCore
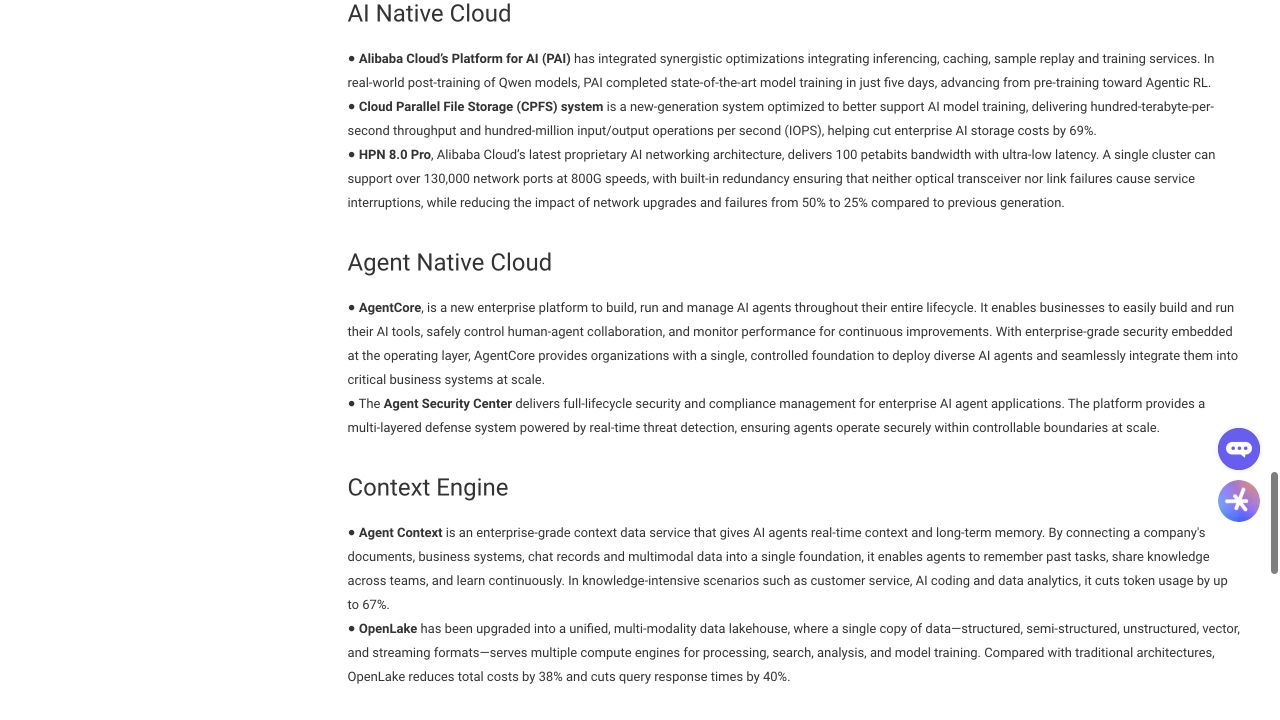
云栖介绍AgentCore用于构建、运行、治理企业Agent,并配套安全中心与沙箱等能力。
企业落地方面,阿里云推出 AgentCore,用于构建、运行和管理智能体的整个生命周期。平台把运行环境、人机协作、安全治理和性能监测放在一起,并配套智能体安全中心及上下文服务。它面向的是长期运行的企业流程,让团队能持续观察和调整智能体,而不只停留在一次演示。
此次发布主体为阿里云。平台将运行环境、人机协作、安全治理与性能监测贯通,并配套安全中心和上下文服务,面向企业智能体的长期运行。
原始来源:阿里云 ↗
22 / 开源模型
MiMo-V2.6 技术进展
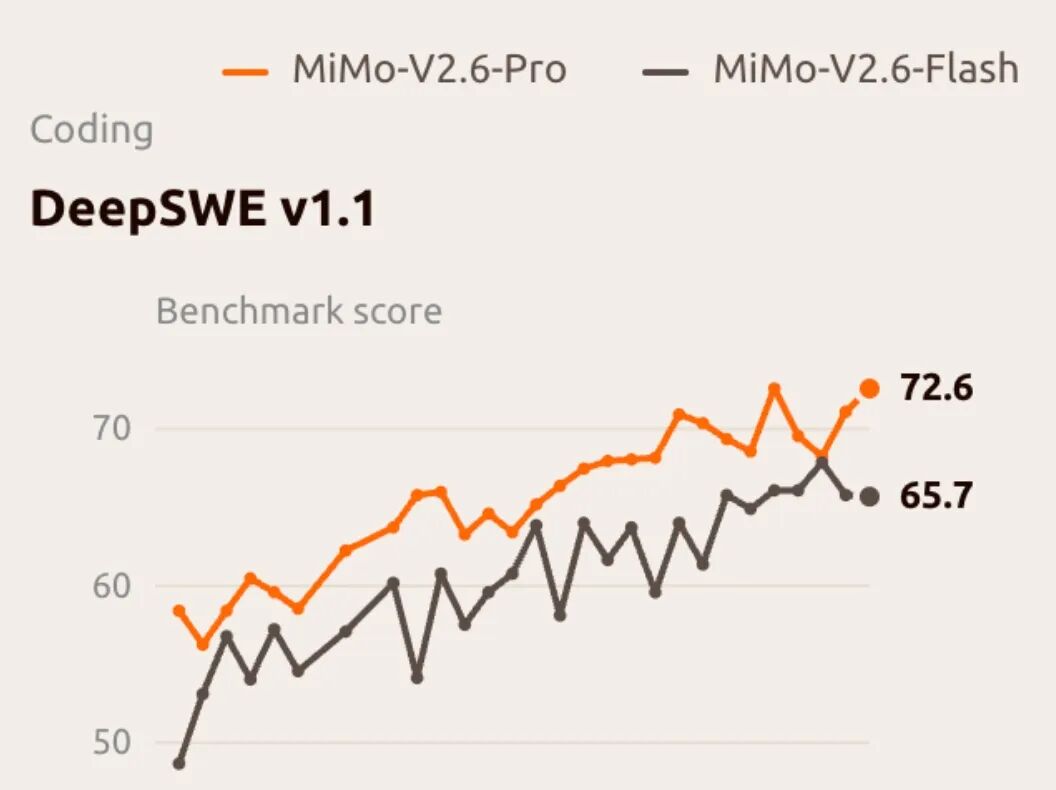
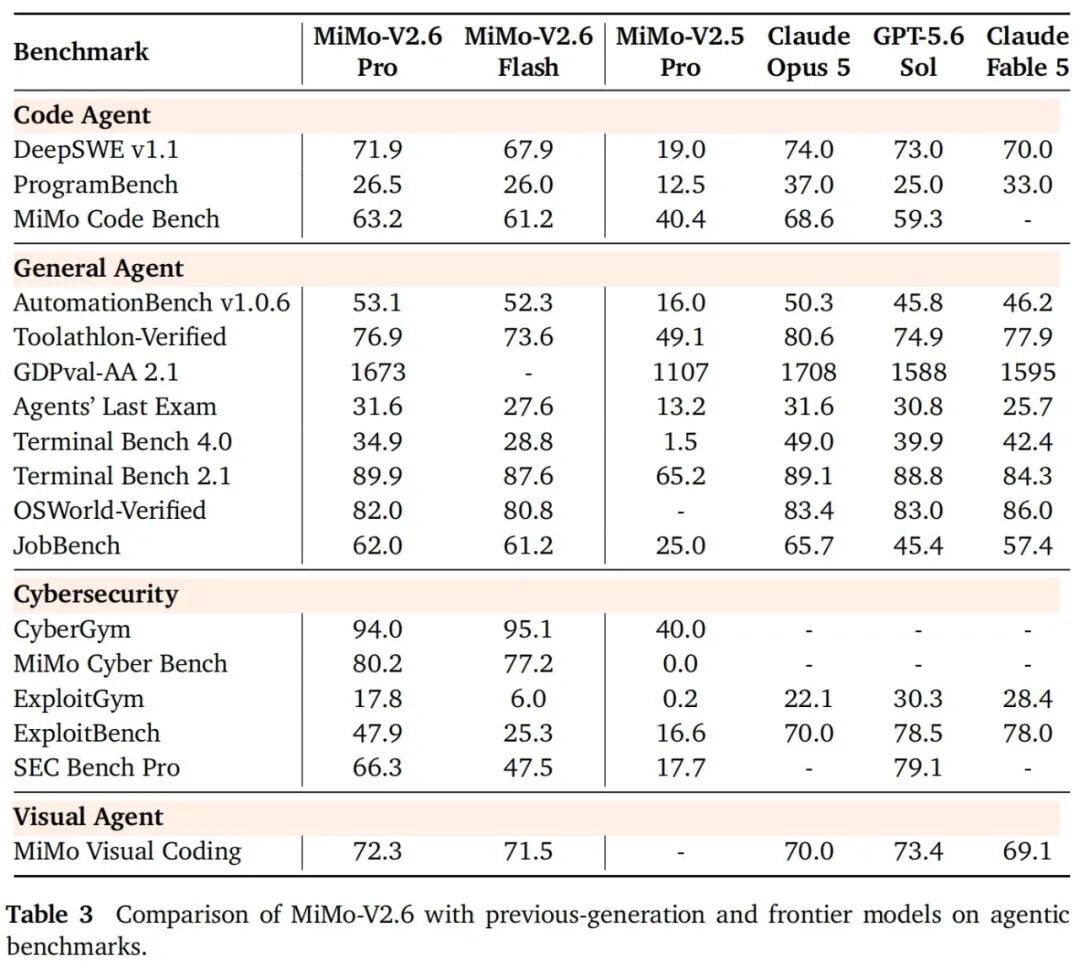
小米9月22日中文技术长文继续披露MiMo-V2.6系列的强化学习与自我提升路线,为前一日模型发布补充技术解释。
小米九月二十二日的技术长文,为 MiMo 二点六补充了强化学习细节。团队通过更大的训练批次、复杂任务环境和更强的评分反馈,扩展智能体训练,并公开相关模型与研究资源。官方记录了不到六天的训练过程,以及样本外软件工程评测的提升。这些资料让研究者可以进一步复现和检验模型的持续改进路径。
本条聚焦 9 月 22 日新技术资料,为此前的模型发布补充强化学习与自我提升解释。图表展示训练曲线及样本外评测,研究资源可用于进一步复现与验证。
原始来源:小米 MiMo ↗
23 / AI硬件
千问眼镜与耳机开启预约
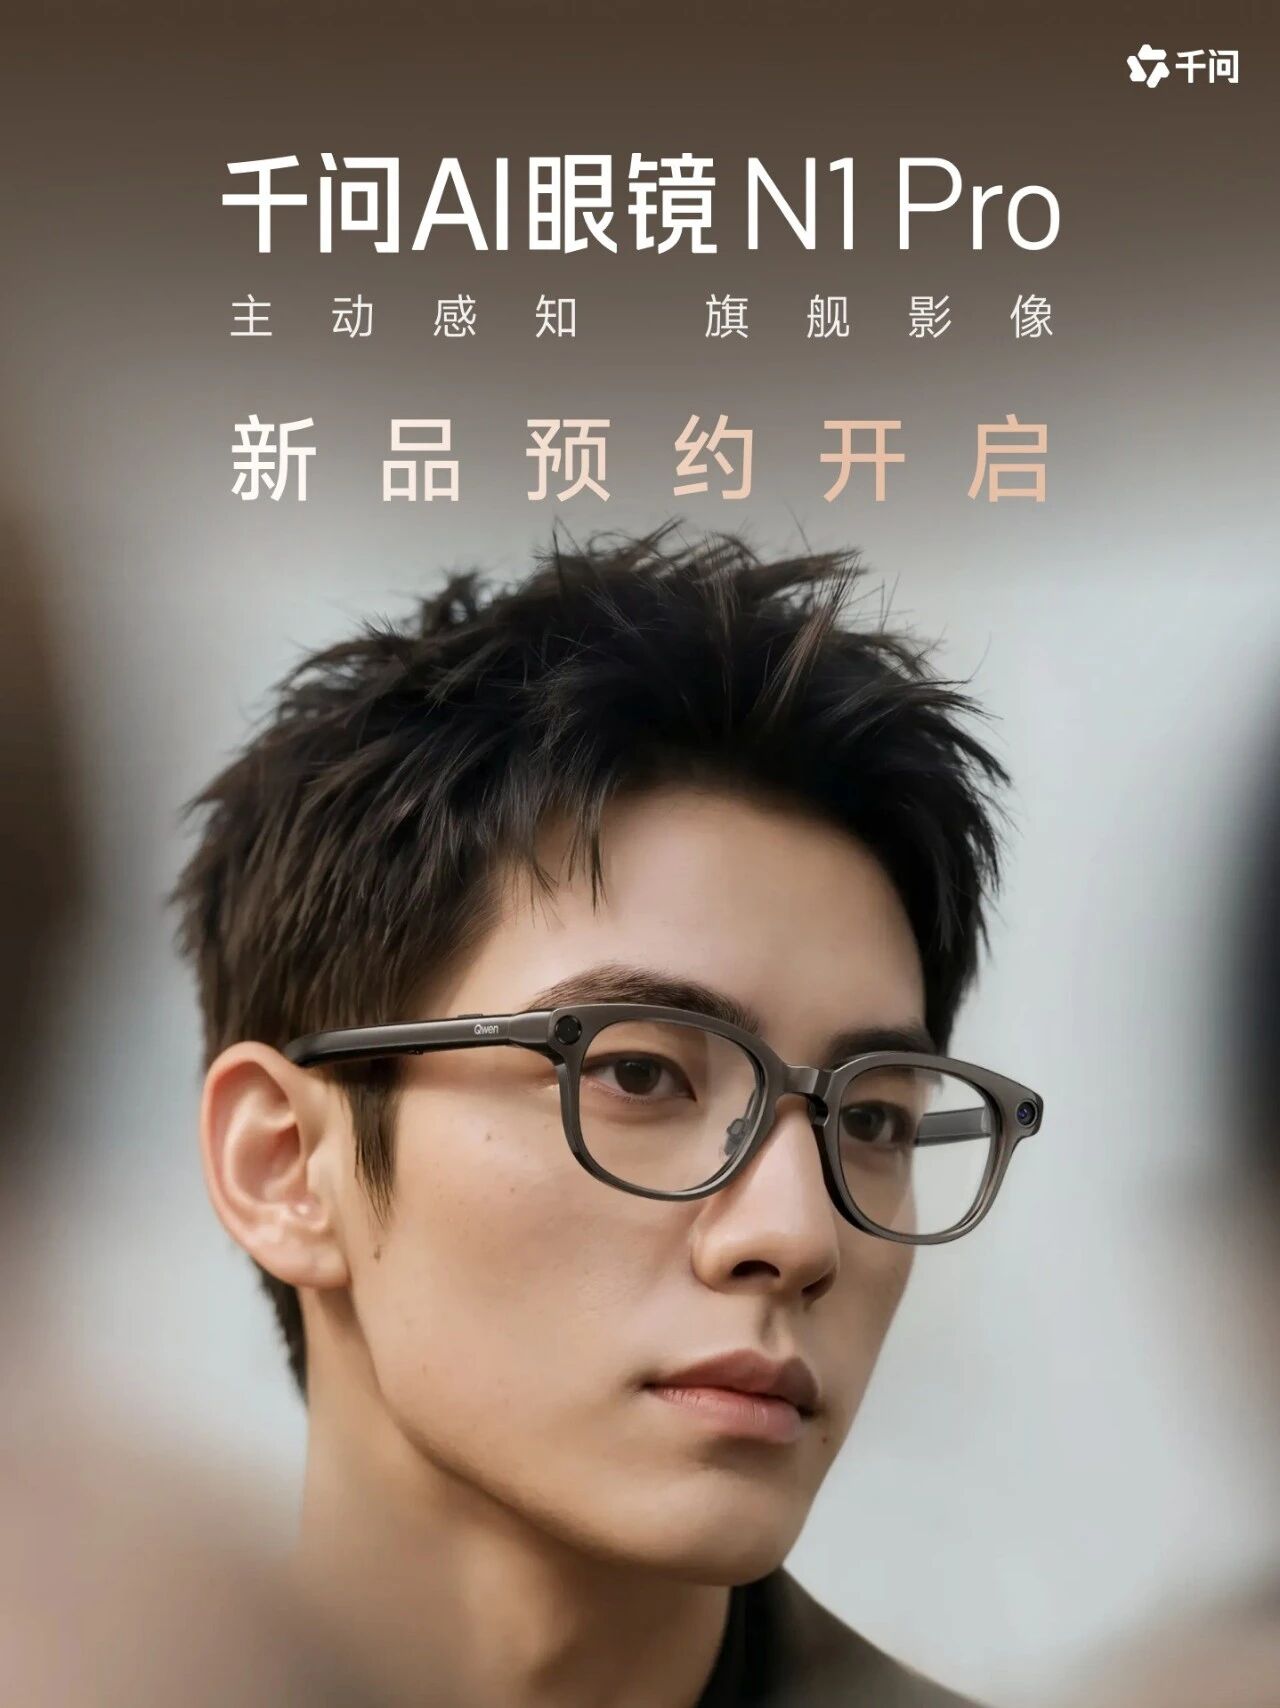
千问官方公布AI眼镜N1、N1 Pro和耳夹式耳机三款新品,分别涉及拍摄、眼动与虹膜支付、翻译和AI听记。
消费硬件方面,千问的 N 一、N 一 Pro 智能眼镜和耳夹式耳机开启预约,计划十月十三日正式发售。官方介绍中,眼镜涉及拍摄、眼动与虹膜支付等能力,耳机则面向翻译和 AI 听记。当前处于预约阶段,价格、服务费用和具体使用条件,需要结合正式上市信息判断。
三款产品目前处于预约阶段,计划 10 月 13 日正式发售。购买前还需核对正式售价、服务费用,以及拍摄、支付、翻译和听记等功能的具体使用条件。
原始来源:千问 ↗
24 / 模型访问
Kimi K3 接入 Bedrock
Kimi官方确认K3已在Bedrock提供,可用于编程、文档分析及长任务,并支持显式提示缓存。
最后,Kimi 官方确认 K 三接入 Amazon Bedrock,为企业提供了新的云端调用渠道,面向编程、文档分析和长任务等场景,并支持显式提示缓存。已经使用 AWS 基础设施的团队,可以按所在地区的模型供应、配额和价格评估接入,把模型能力纳入现有开发与治理流程。
K3 在 Bedrock 的调用为 AWS 用户增加模型选择,并支持显式提示缓存。地区供应、服务配额与价格可结合 AWS 模型说明逐项确认。