OPC 中国 · AI 日报
AI 代理拼实战:GPT-6 Sol Max、Copilot 新版、LongCat 2.5|9月26日 AI 日报
今天精选17条AI新闻。头条:GPT-6 Sol Max 在4000多次真实代理会话中登上 Agent Arena 综合榜第六;另有新版Copilot串起办公、代码与持续任务,Claude插件统一提交入口、Claude Code额度用完也能收尾,Gemini代打电话,以及美团 LongCat 2.5 Preview 与 DeepSeek Harness 桌面预览。
酷恩选题,AI辅助整理与配音;原始来源逐条列出。
本期目录 · 先国外,后国内
- GPT-6 Sol Max Agent Arena 排第六
- Copilot 新版 从办公走向持续任务
- Claude 插件 有了统一提交入口
- Claude Code 额度用完也能收尾
- 科学终端评测 Astra 与 Opus 接近
- Gemini 代打电话 预约、询价、等转接
- Claude Science 算出九圈振幅
- 模拟经营商店 Sol 成本更低
- Deel 用 Jev 做问题匹配与费用分类
- Grok 4.7 能力与任务成本同看
- OpenCode Go DeepSeek 额度转长期
- ChatGPT 新增 安全活动记录
- Muse 邀请商家 连接个人 AI 助手
- Colossus 算力 公布现有与后续计划
- Copilot 进 Slack 与 Teams 聊天上下文更完整
- LongCat 2.5 Preview 百万上下文与兼容接口
- DeepSeek Harness 进入桌面预览阶段
国外新闻
01 / 代理实战评测
GPT-6 Sol Max Agent Arena 排第六
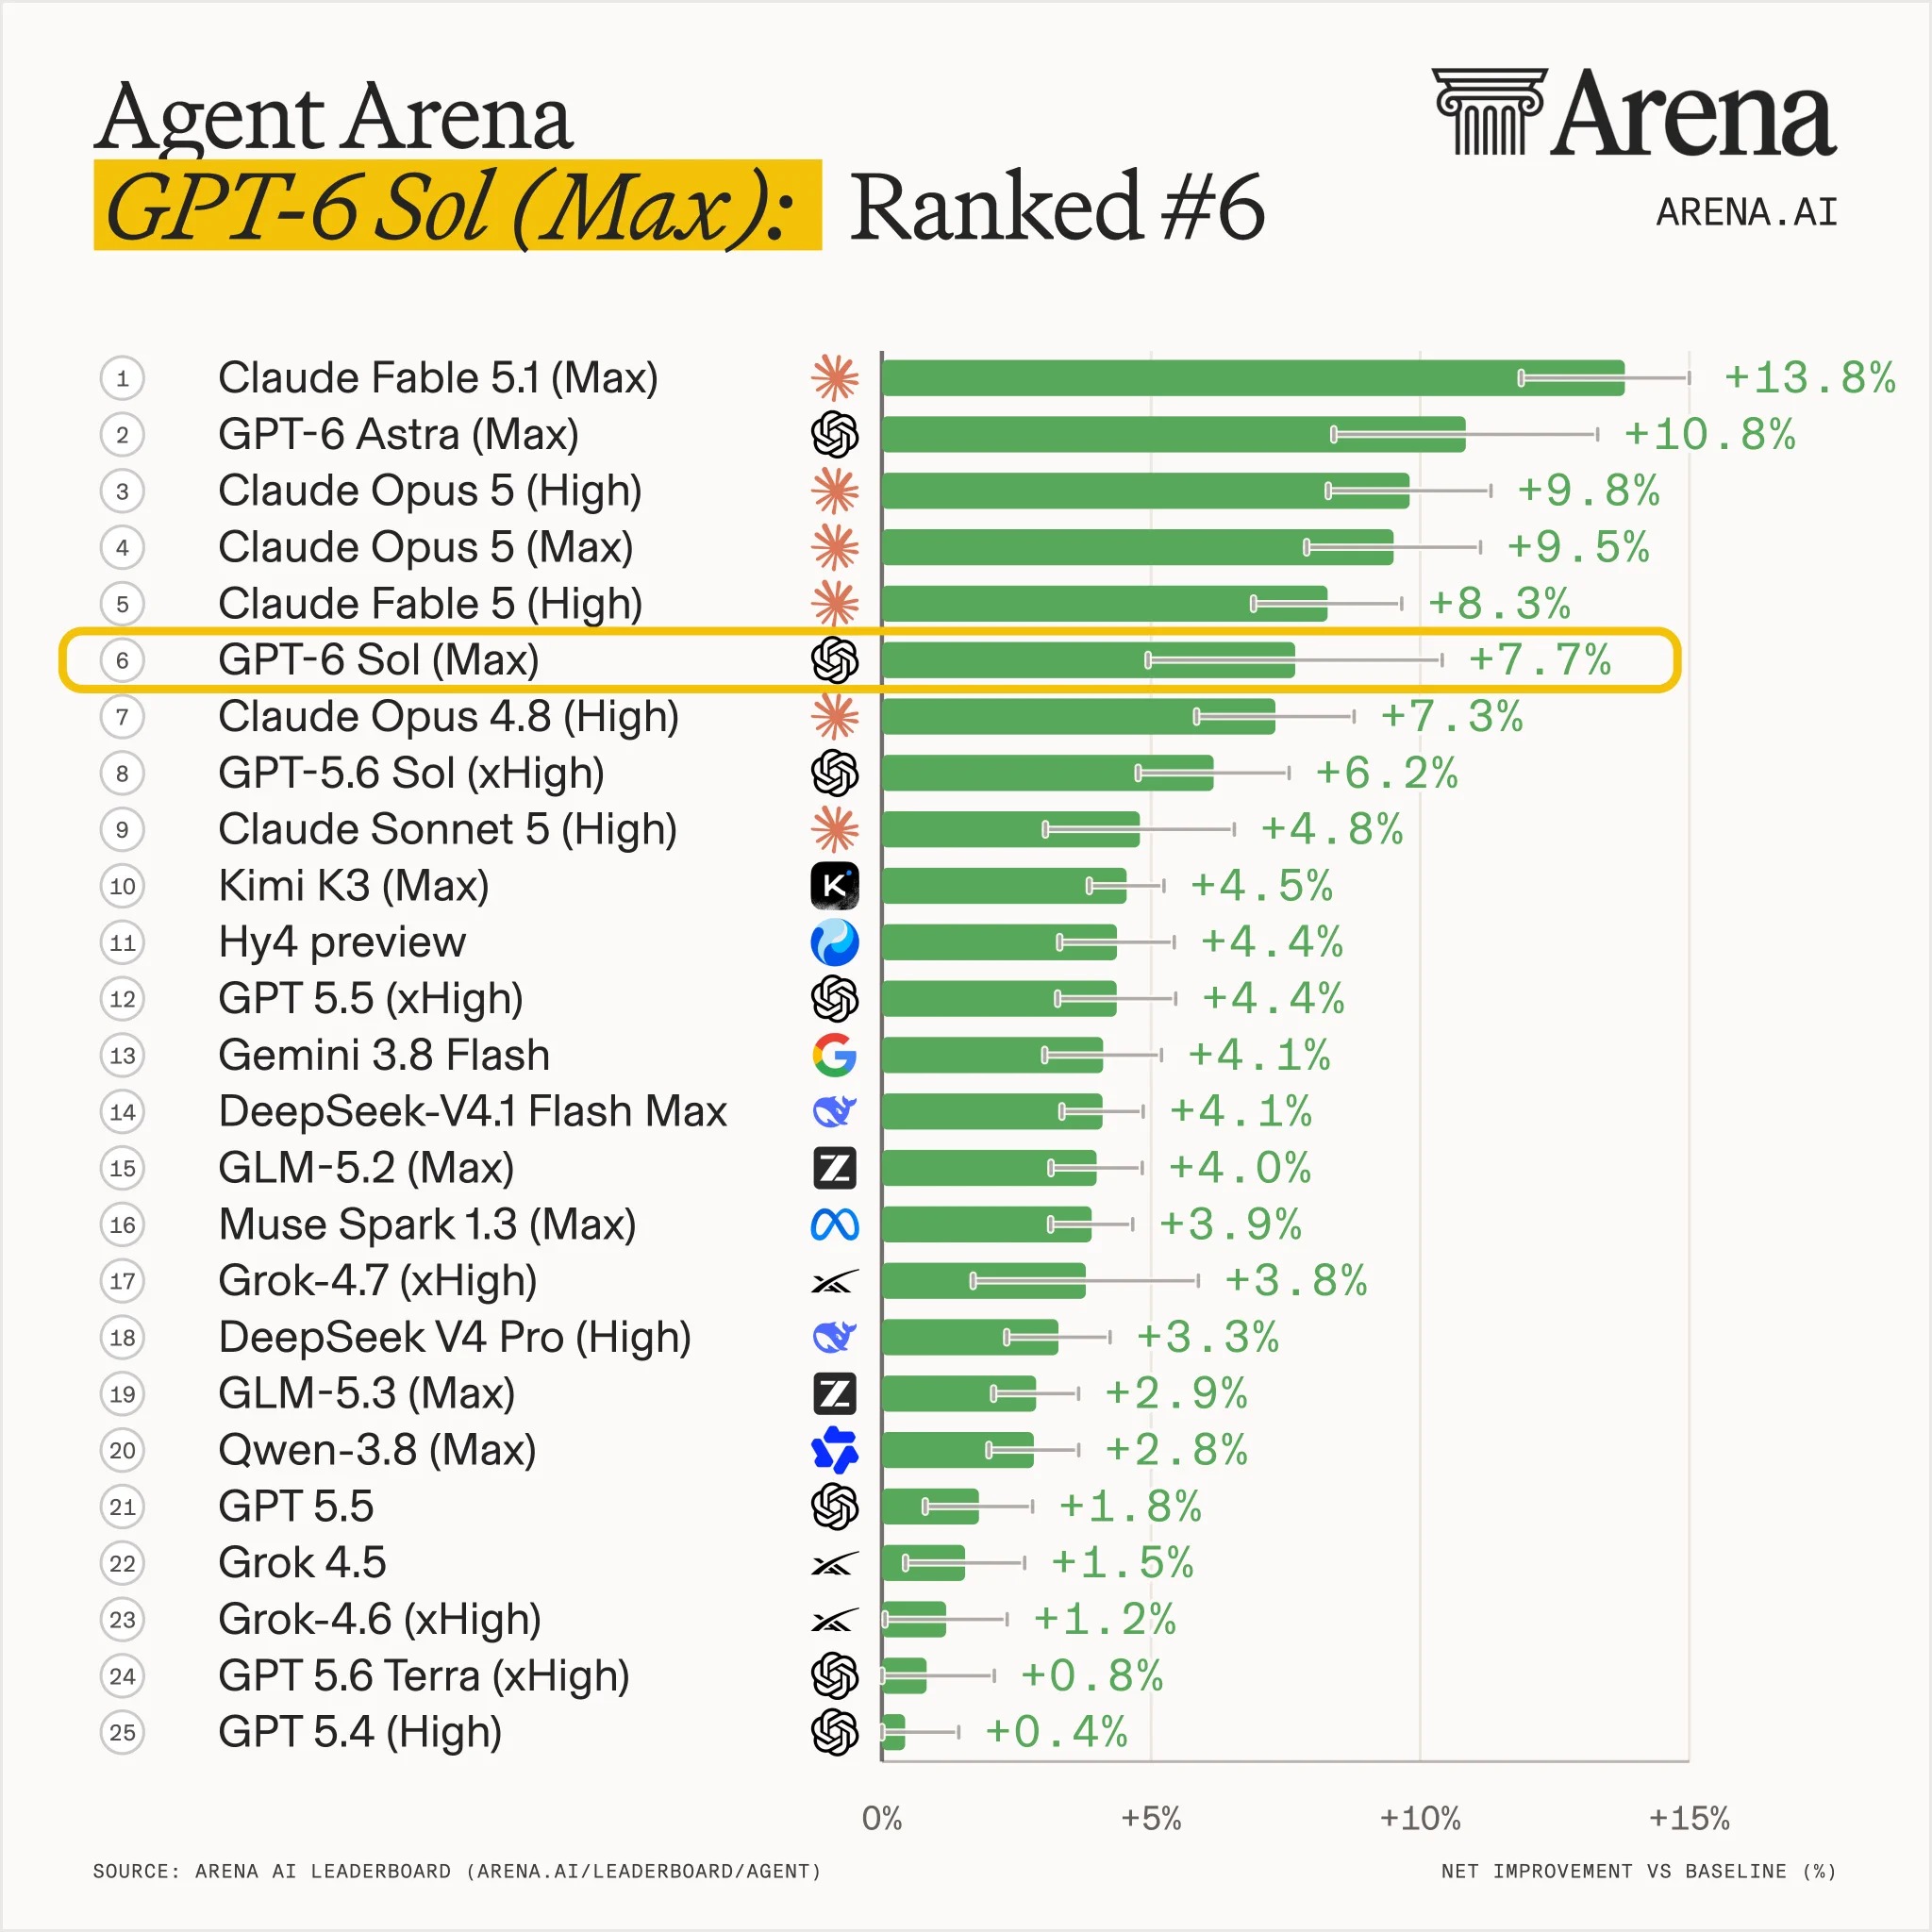
Arena 公布 GPT-6 Sol Max 的 Agent Arena 结果,在4000多次真实代理会话中净改善指标约7.7%,排名第六。
这次结果来自 Arena 的真实代理会话,任务涉及网页、文件系统和终端工具,GPT-6 Sol Max 在该期榜单排第六。发布者同时比较了上一代 Sol 的表现及模型 token 价格。
榜单衡量的是特定会话样本和推理设置下的结果。对实际使用者而言,可以把它与自己的任务成功率、响应时间和单次费用一起判断。
原始来源:Arena ↗
02 / 工作代理
Copilot 新版 从办公走向持续任务
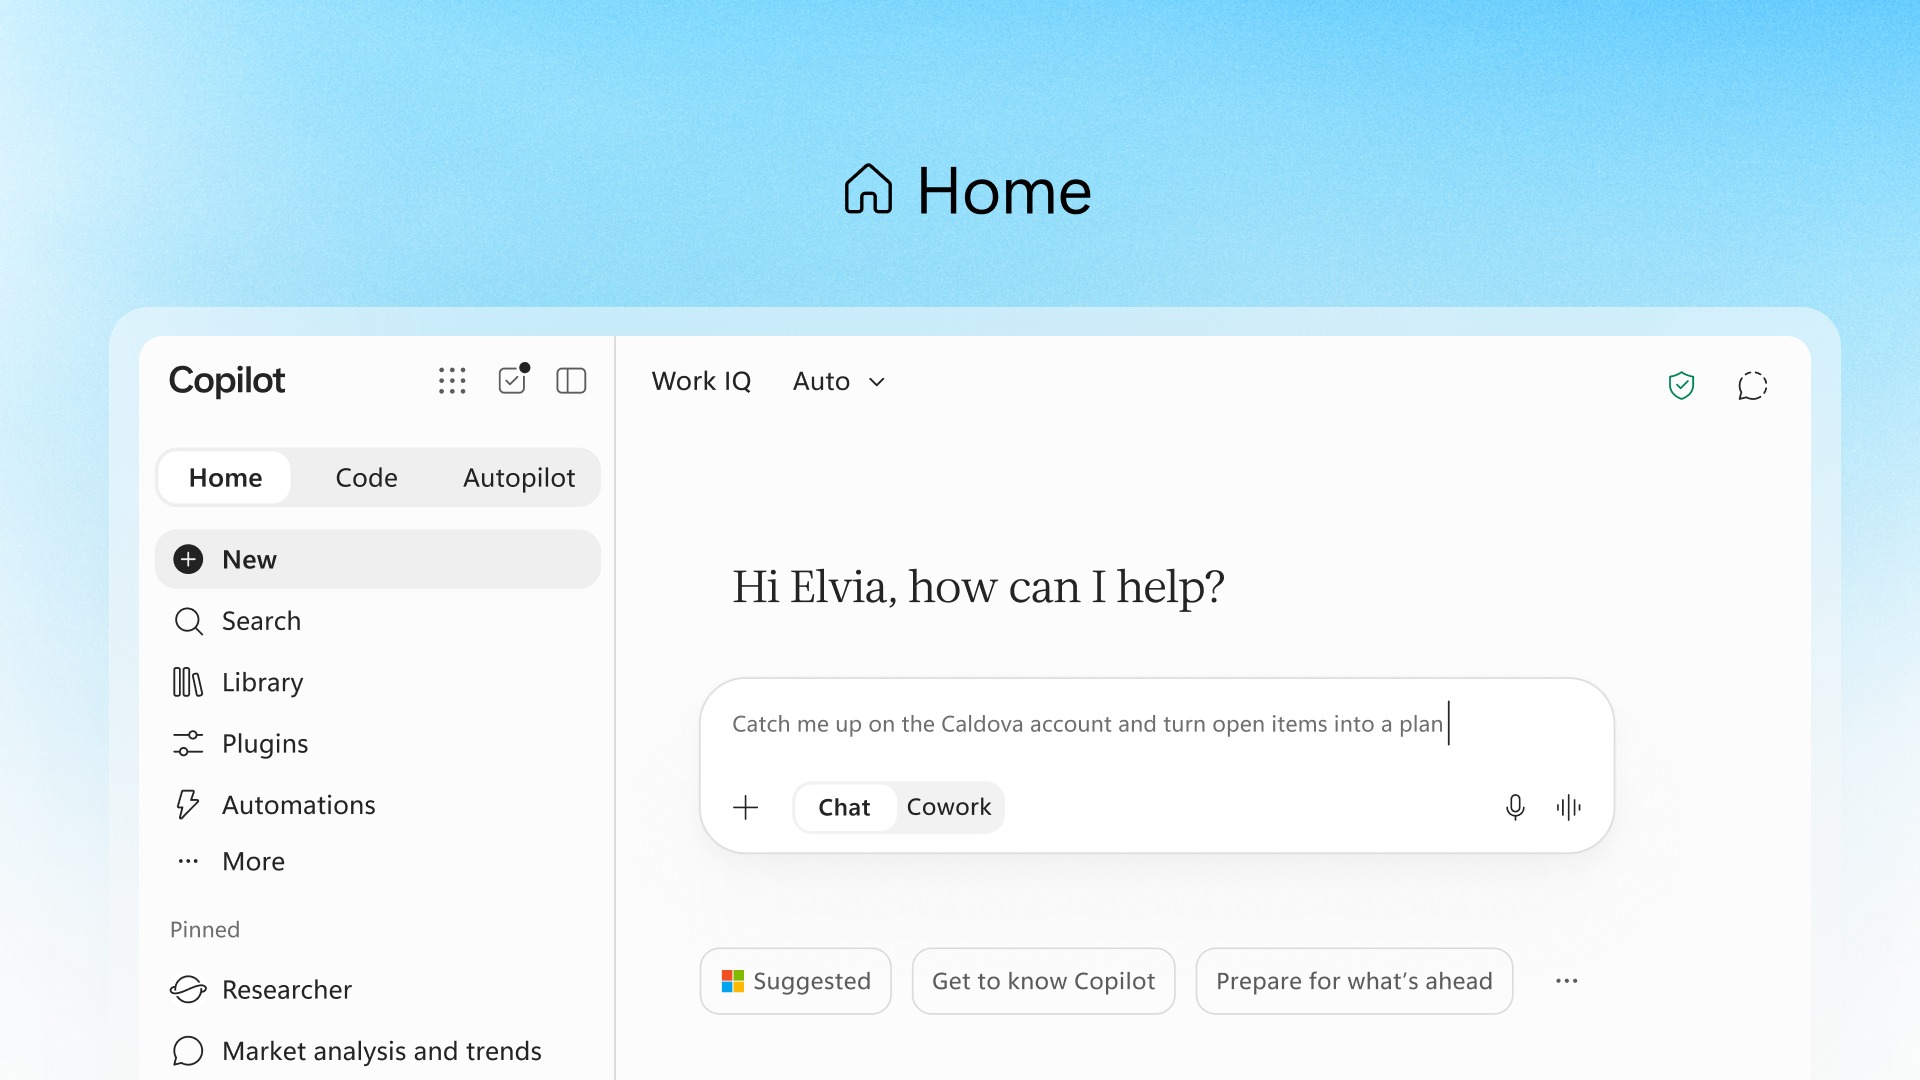
微软公布新版 Copilot,将 Home、Code 与 Autopilot 连接成统一工作体验,并按阶段开放预览。
微软9月25日介绍新版 Copilot。Home 把聊天与协作工作结合,用户可围绕可编辑文档持续沟通;Code 面向代码和应用构建,Autopilot 则处理持续运行的云端任务。
Home、Code 将在未来数周向 Frontier 用户推进,Code 计划月底预览,Autopilot 计划月底私测。代理工作采用用量计费,普通聊天与 Office 能力继续按对应许可规则提供。
原始来源:Microsoft ↗
03 / 插件生态
Claude 插件 有了统一提交入口
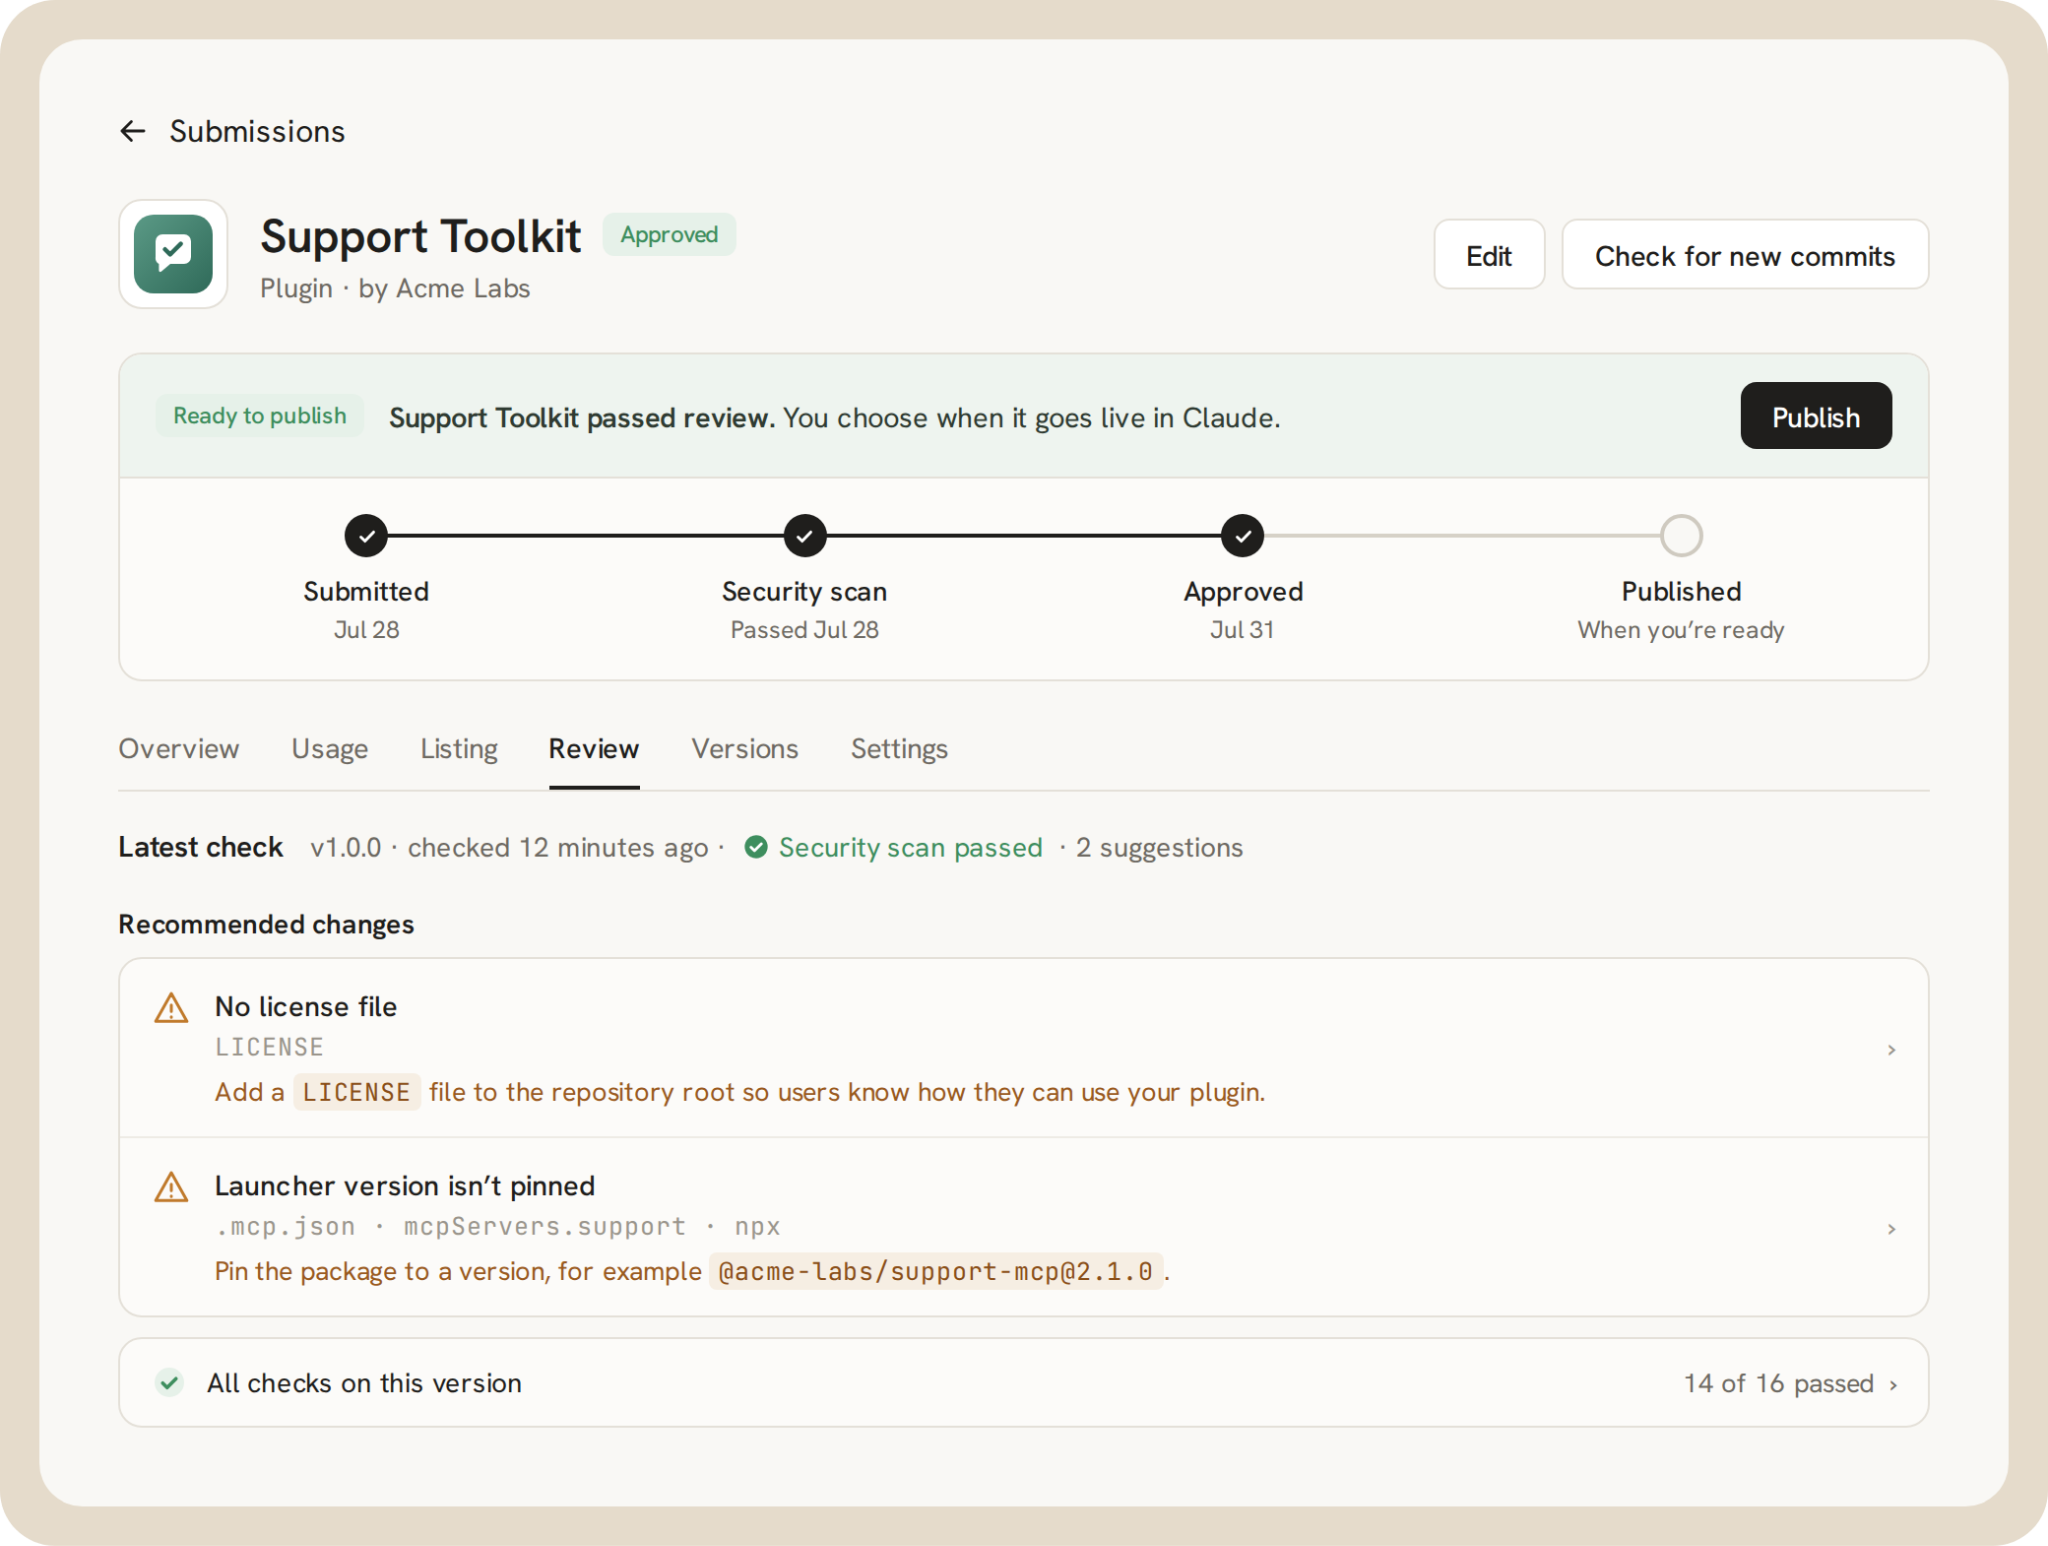
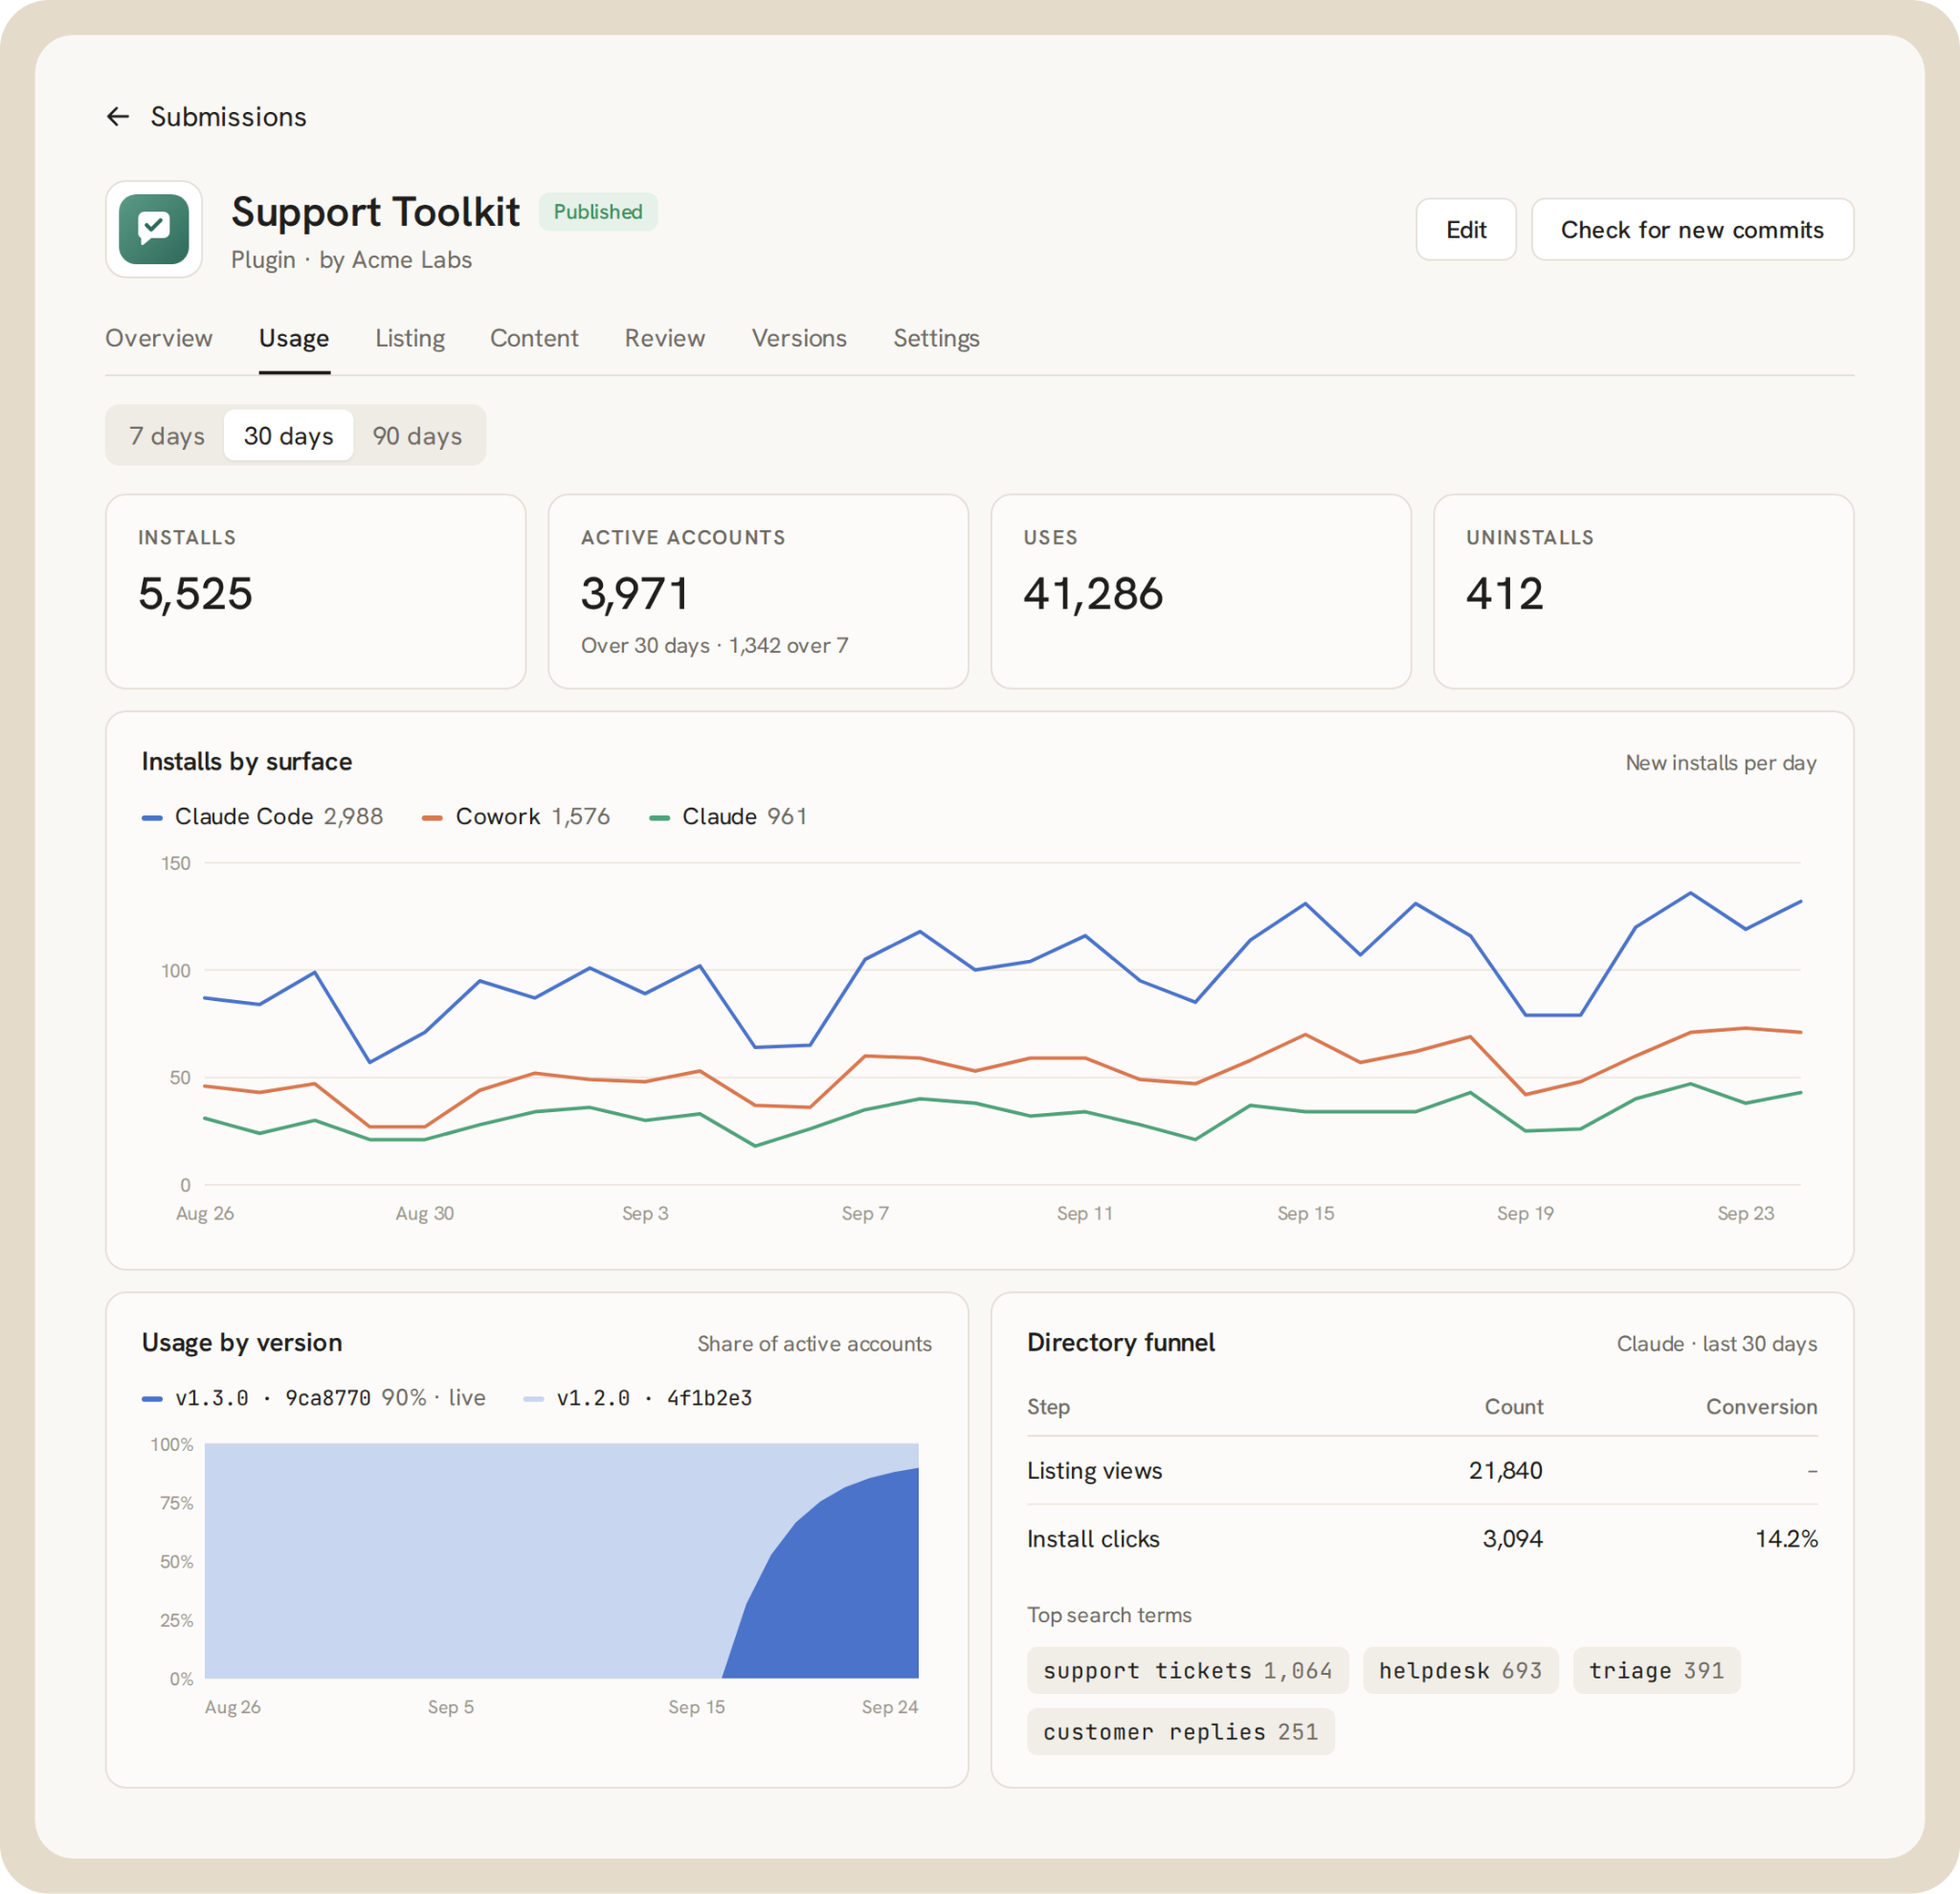
Anthropic 推出 Claude 插件提交入口,支持远程 MCP 与 GitHub 插件包,并提供审核进度和使用分析。
开发者可以通过统一入口提交远程 MCP 服务,或包含技能、命令、工具等能力的 GitHub 插件包。提交后会经过自动校验、安全扫描与审核反馈。
入口同时提供提交状态与使用分析。相关能力面向付费 Claude 计划,统一的插件发现体验将在未来数周推出,开发者可先完善插件和提交材料。
原始来源:Anthropic ↗
04 / 开发工具额度
Claude Code 额度用完也能收尾
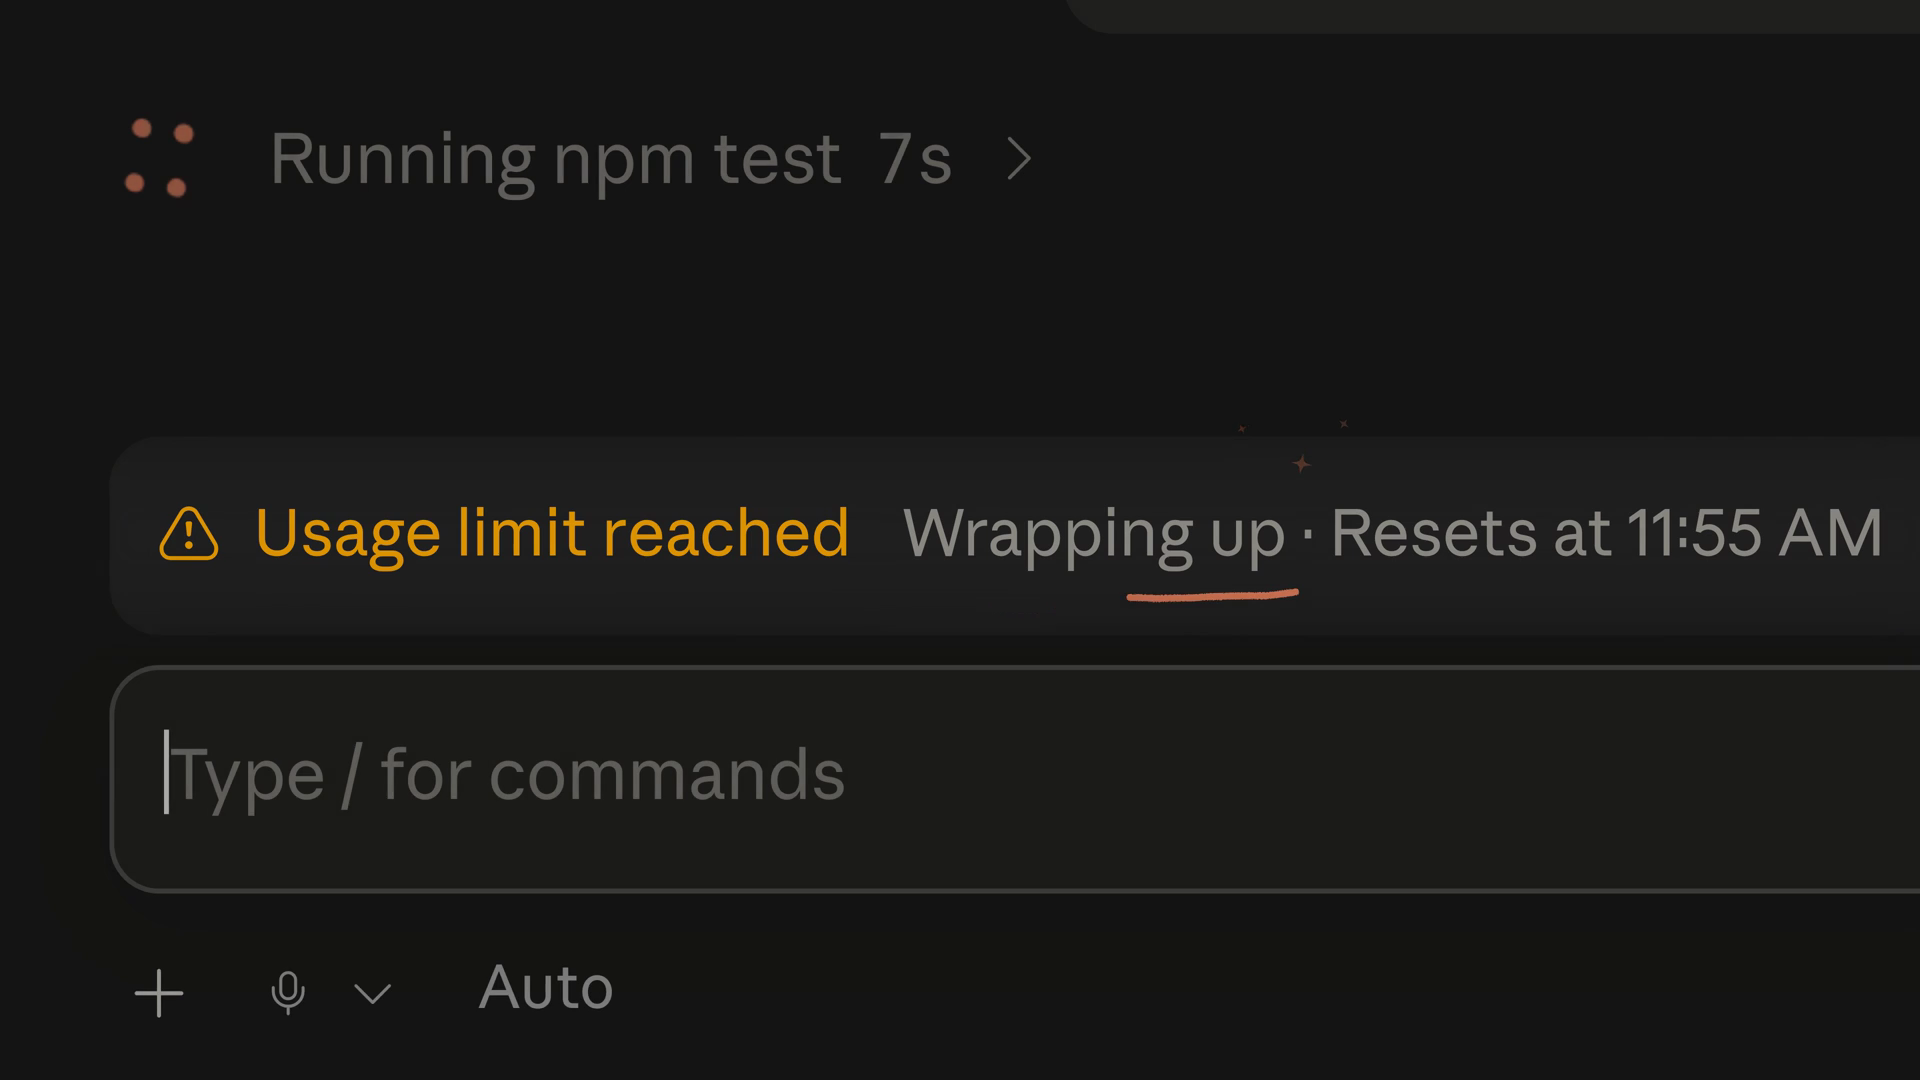
Claude Code 增加任务收尾机制,在五小时用量窗口触顶后,使用少量固定周额度寻找自然停止点。
Anthropic 公布新的收尾体验,减少长任务在五小时窗口用量触顶时被直接打断的情况。继续工作使用的是周额度。
Pro 用户每周可使用一次;Max 和 Team Premium 按五小时窗口提供。继续使用额外用量时仍需遵循对应计费设置。
原始来源:Anthropic ↗
05 / 模型评测
科学终端评测 Astra 与 Opus 接近
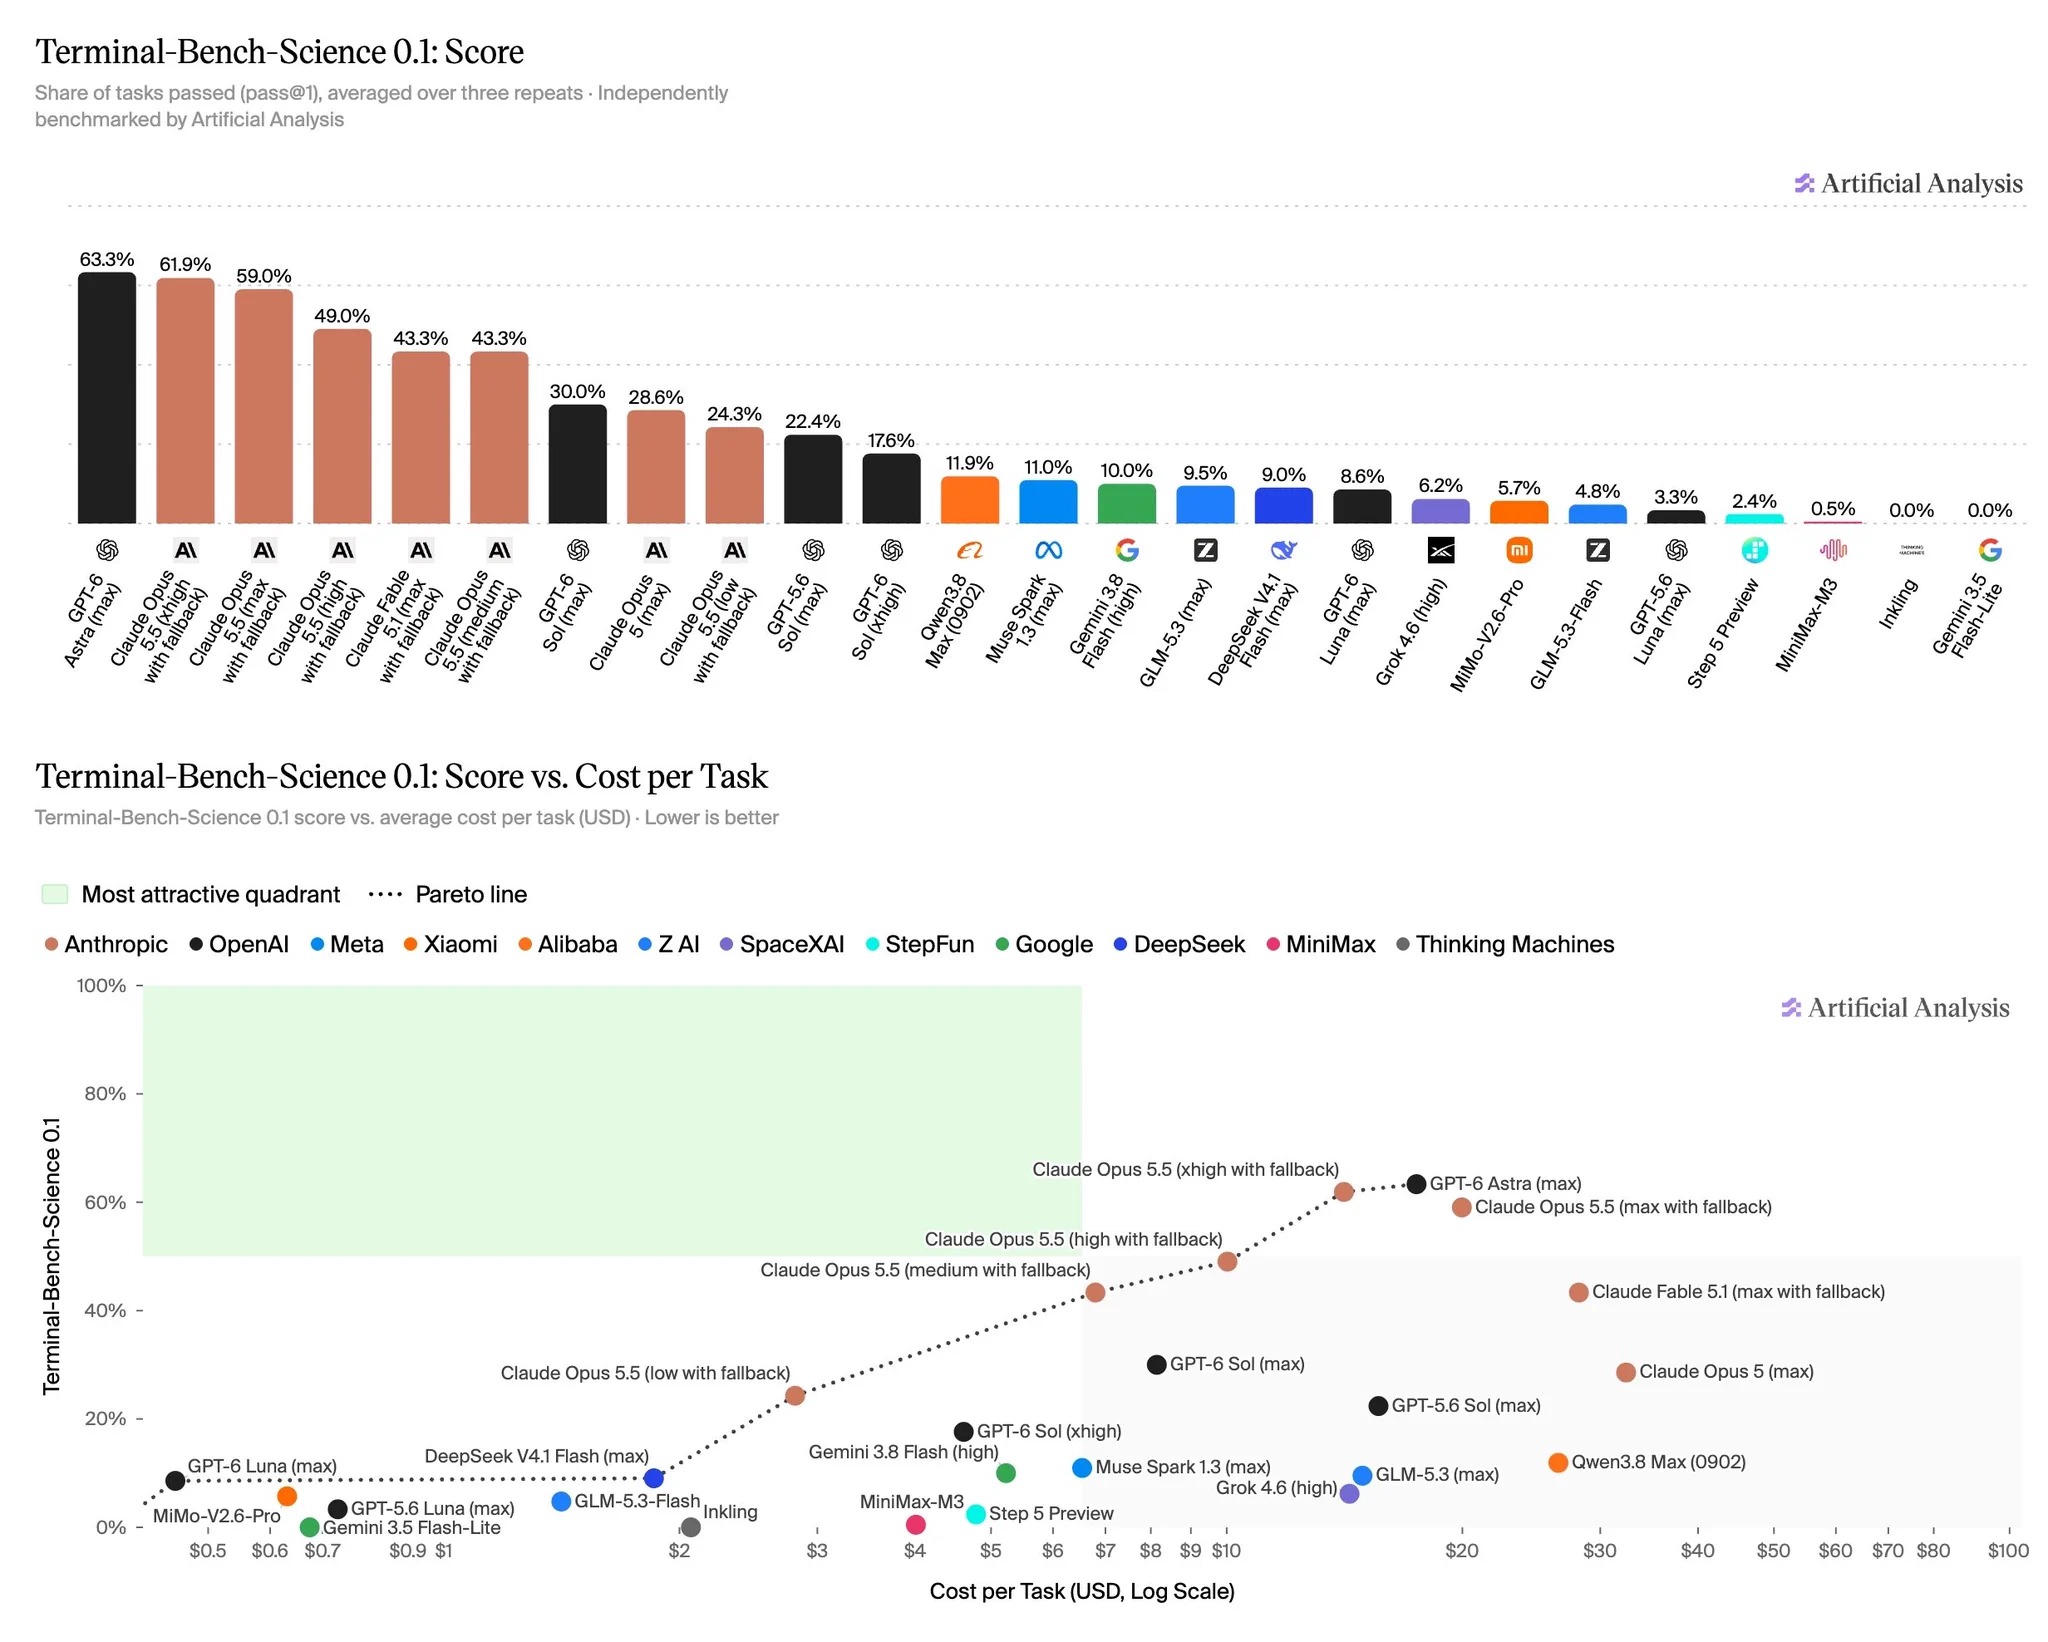
Artificial Analysis 公布 Terminal-Bench Science 0.1 结果:Astra Max 为63%,Opus 5.5 XHigh 为62%。
新评测包含五个科学领域的70项终端任务,并使用统一代理框架比较模型完成科学工作的能力。公布结果中,GPT-6 Astra Max 为63%,Claude Opus 5.5 XHigh 为62%。
Opus 的不同推理档位在成绩和费用上也有明显差异。两项相近成绩适合看作该测试条件下的表现,模型选择仍要结合实际科学任务及成本。
06 / 手机代理
Gemini 代打电话 预约、询价、等转接
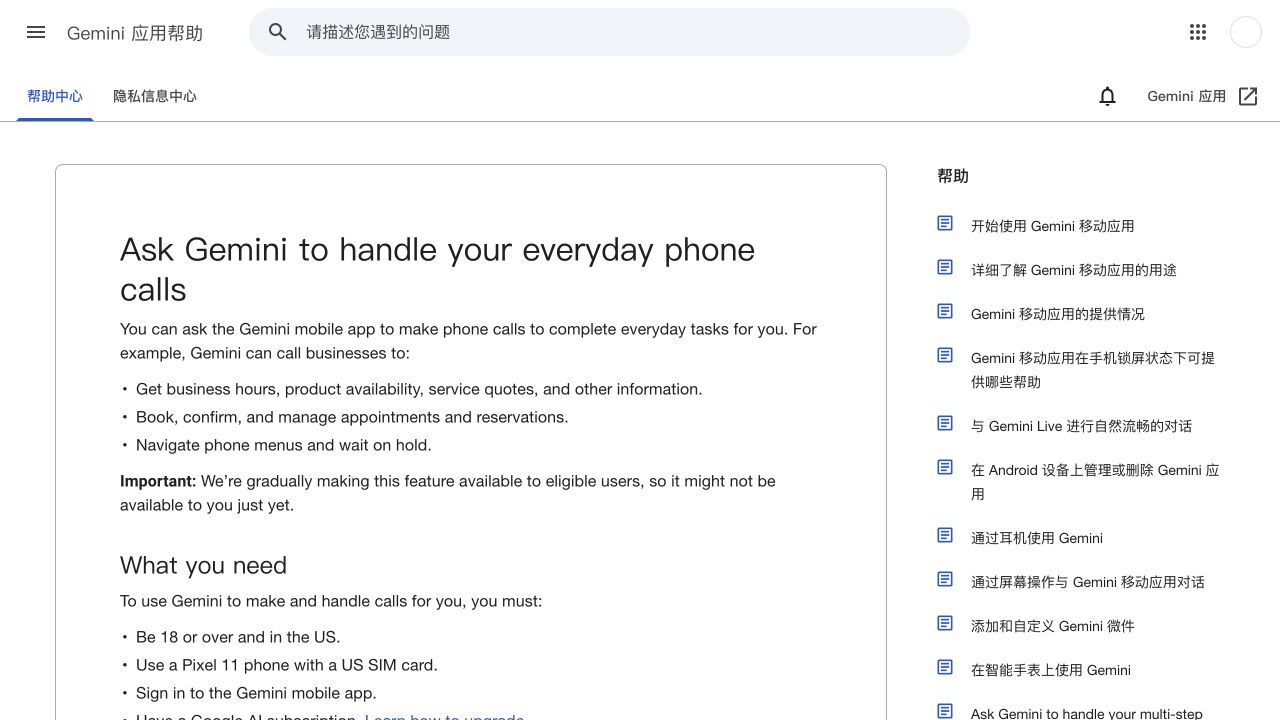
Google 逐步开放 Gemini 代打电话功能,首批面向符合设备和订阅条件的美国成年用户。
Gemini 可联系商家查询营业时间、服务报价,预约或修改预订,并等待电话菜单转接。拨号前,用户需要核对目标号码和准备分享的信息;通话中可查看实时文字、收听或接管。
当前要求美国18岁以上用户、带美国 SIM 的 Pixel 11、Google AI 订阅、Phone by Google 公测版和英语设备语言。仅支持美国号码,使用本机号码与移动网络,且不能代为付款或分享敏感金融信息。
原始来源:Google ↗
07 / AI 科研
Claude Science 算出九圈振幅
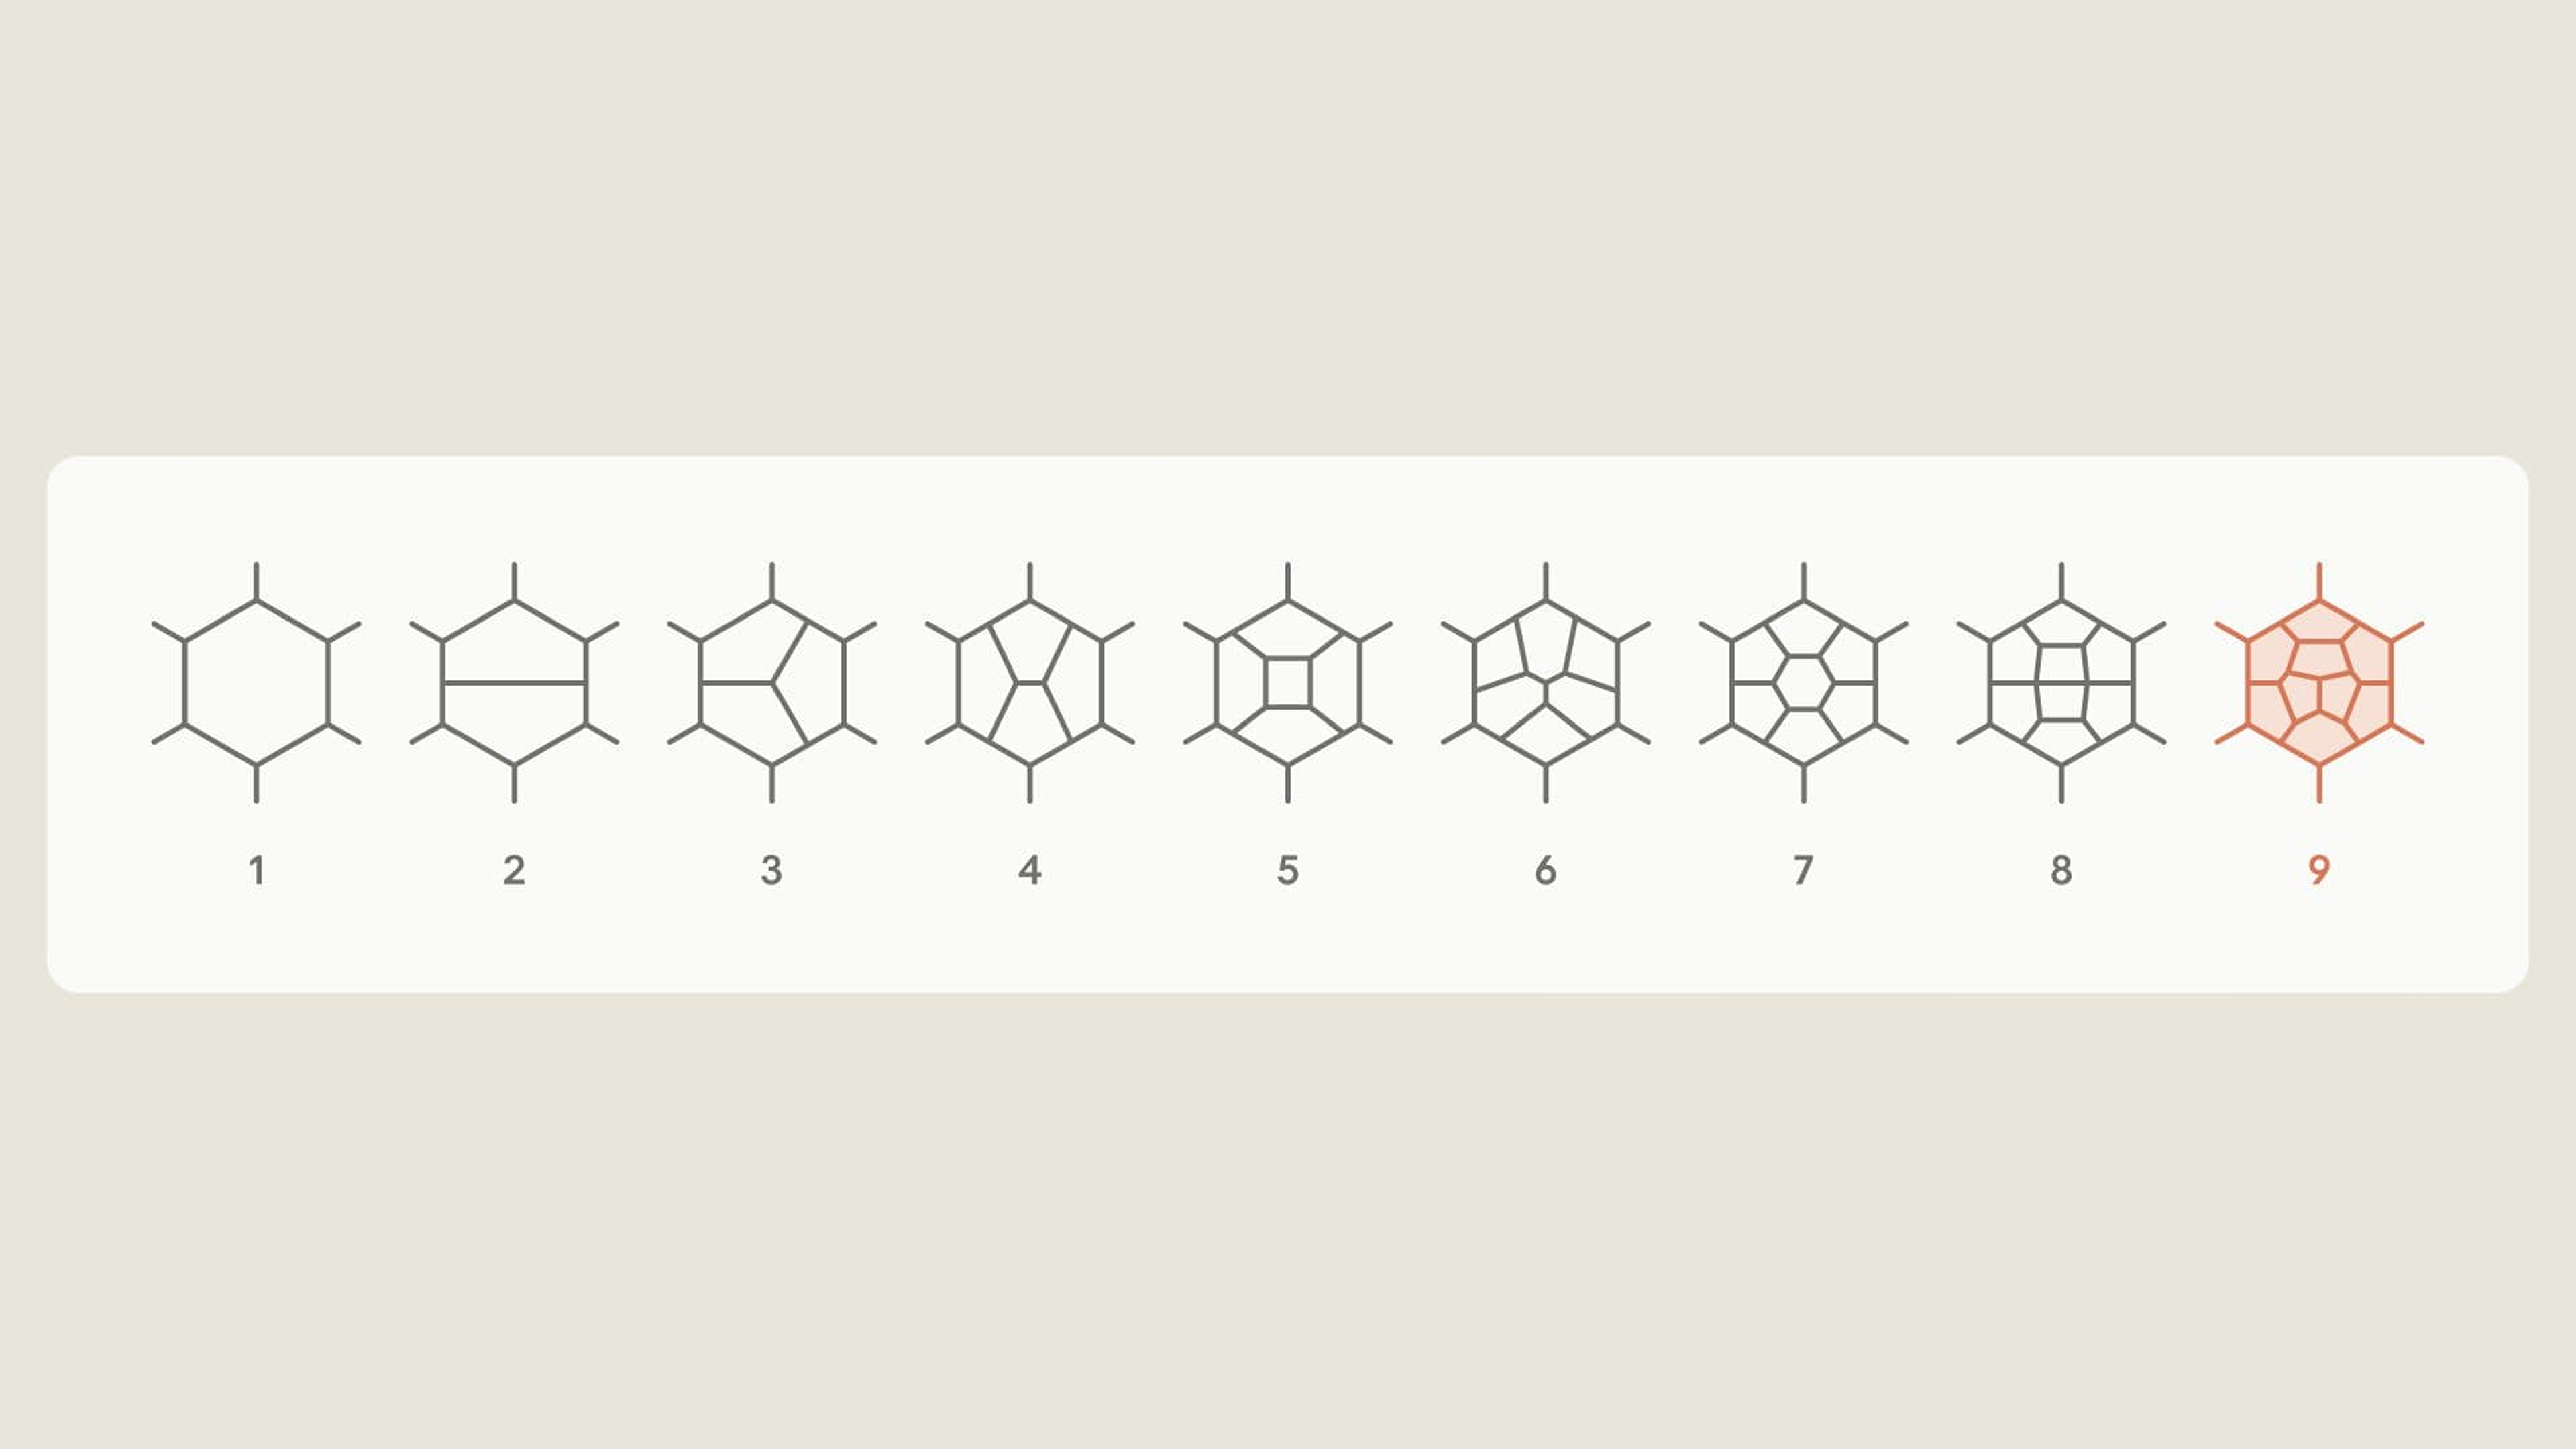
Anthropic 发布研究者文章,介绍 Claude Science 使用 Fable 5.1 完成特定理论中的九圈振幅计算。
计算涉及平面 N=4 超杨米尔斯理论中的振幅问题。Claude Science 使用既有研究方法搭建代码、组织算力并完成计算,研究者 Lance Dixon 随后验证结果。
工作在9月25日前已开展,本次为成果与过程披露。文章强调其价值在复杂计算流程的可靠执行和工程组织;使用的物理方法建立在已有研究之上。
原始来源:Anthropic / 研究者 ↗
08 / 商业代理评测
模拟经营商店 Sol 成本更低
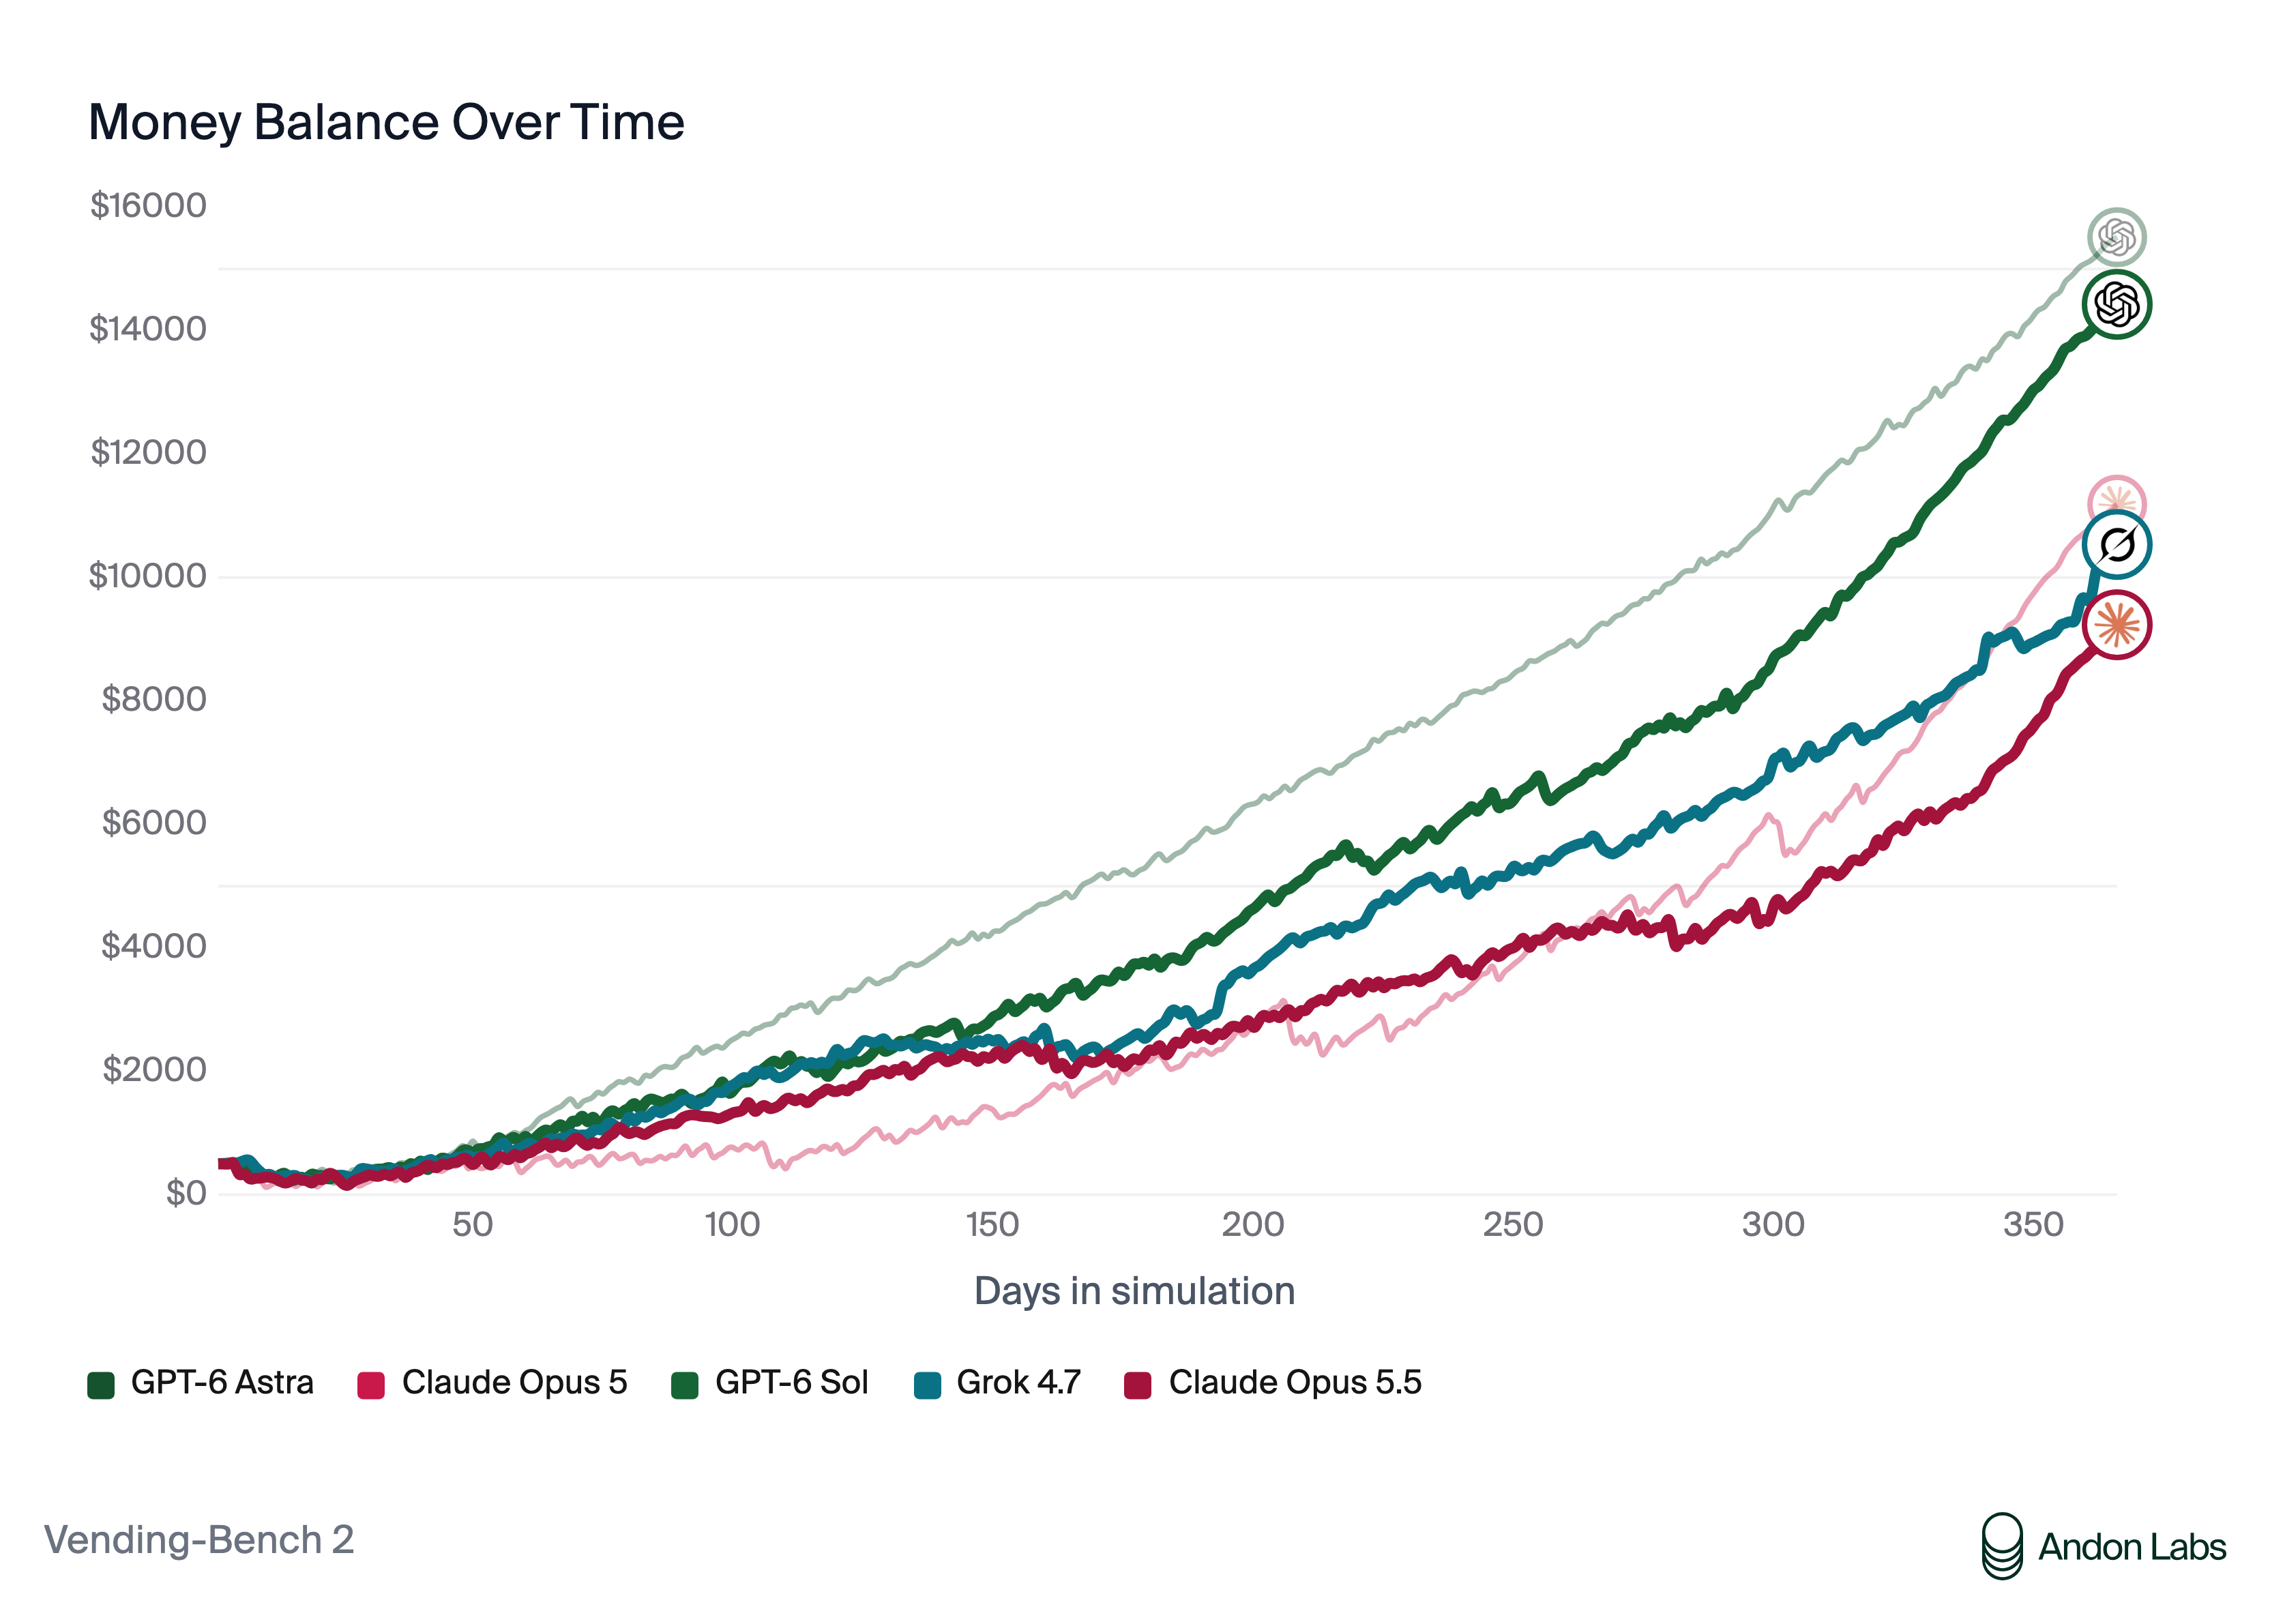
Andon Labs 的 VendingBench 2 新结果显示,Sol 达到约 Astra 93%的模拟经营收益,API 花费约为八分之一。
在模拟经营商店的测试中,GPT-6 Sol 的平均资金余额约为14428美元,Astra 为15515美元;对应每轮 API 费用约104美元与810美元。
实验还比较了 Opus 5.5 和 Grok 4.7,并测试多个代理同场经营的表现。这些都是特定模拟环境和有限轮次的结果,研究也记录了代理在竞争中的不当策略。
原始来源:Andon Labs ↗
09 / 企业 AI 应用
Deel 用 Jev 做问题匹配与费用分类
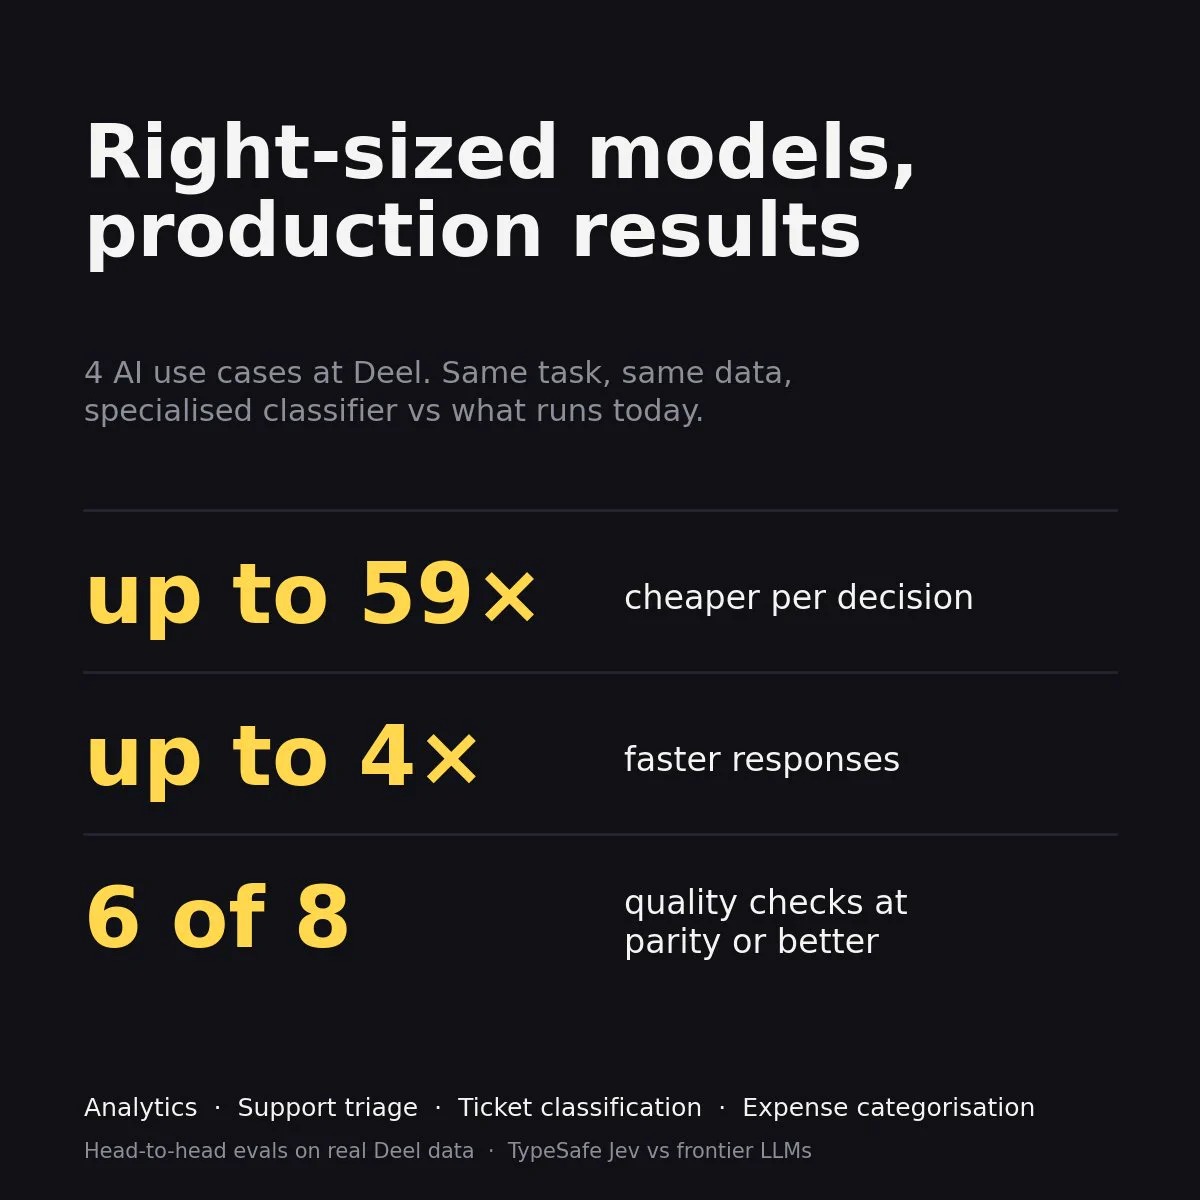
TypeSafe 与 Deel 的案例披露,Jev 在重复分析问题匹配和费用分类任务中提高准确率,并提供测试阶段的提速结果。
按公司公开案例,把重复分析问题匹配到已批准答案的准确率从70%提高到97%;费用分类以人工审核结果为参照,从50%提高到86%。团队还对离线评估与影子生产测试分别报告了提速情况。
这些指标限定在该公司的具体任务与数据中,流程包含人工复核。案例价值在于把结构化业务判断、测试和上线观察连接起来,而非只比较单次问答。
原始来源:TypeSafe / Deel ↗
10 / 代理实战评测
Grok 4.7 能力与任务成本同看
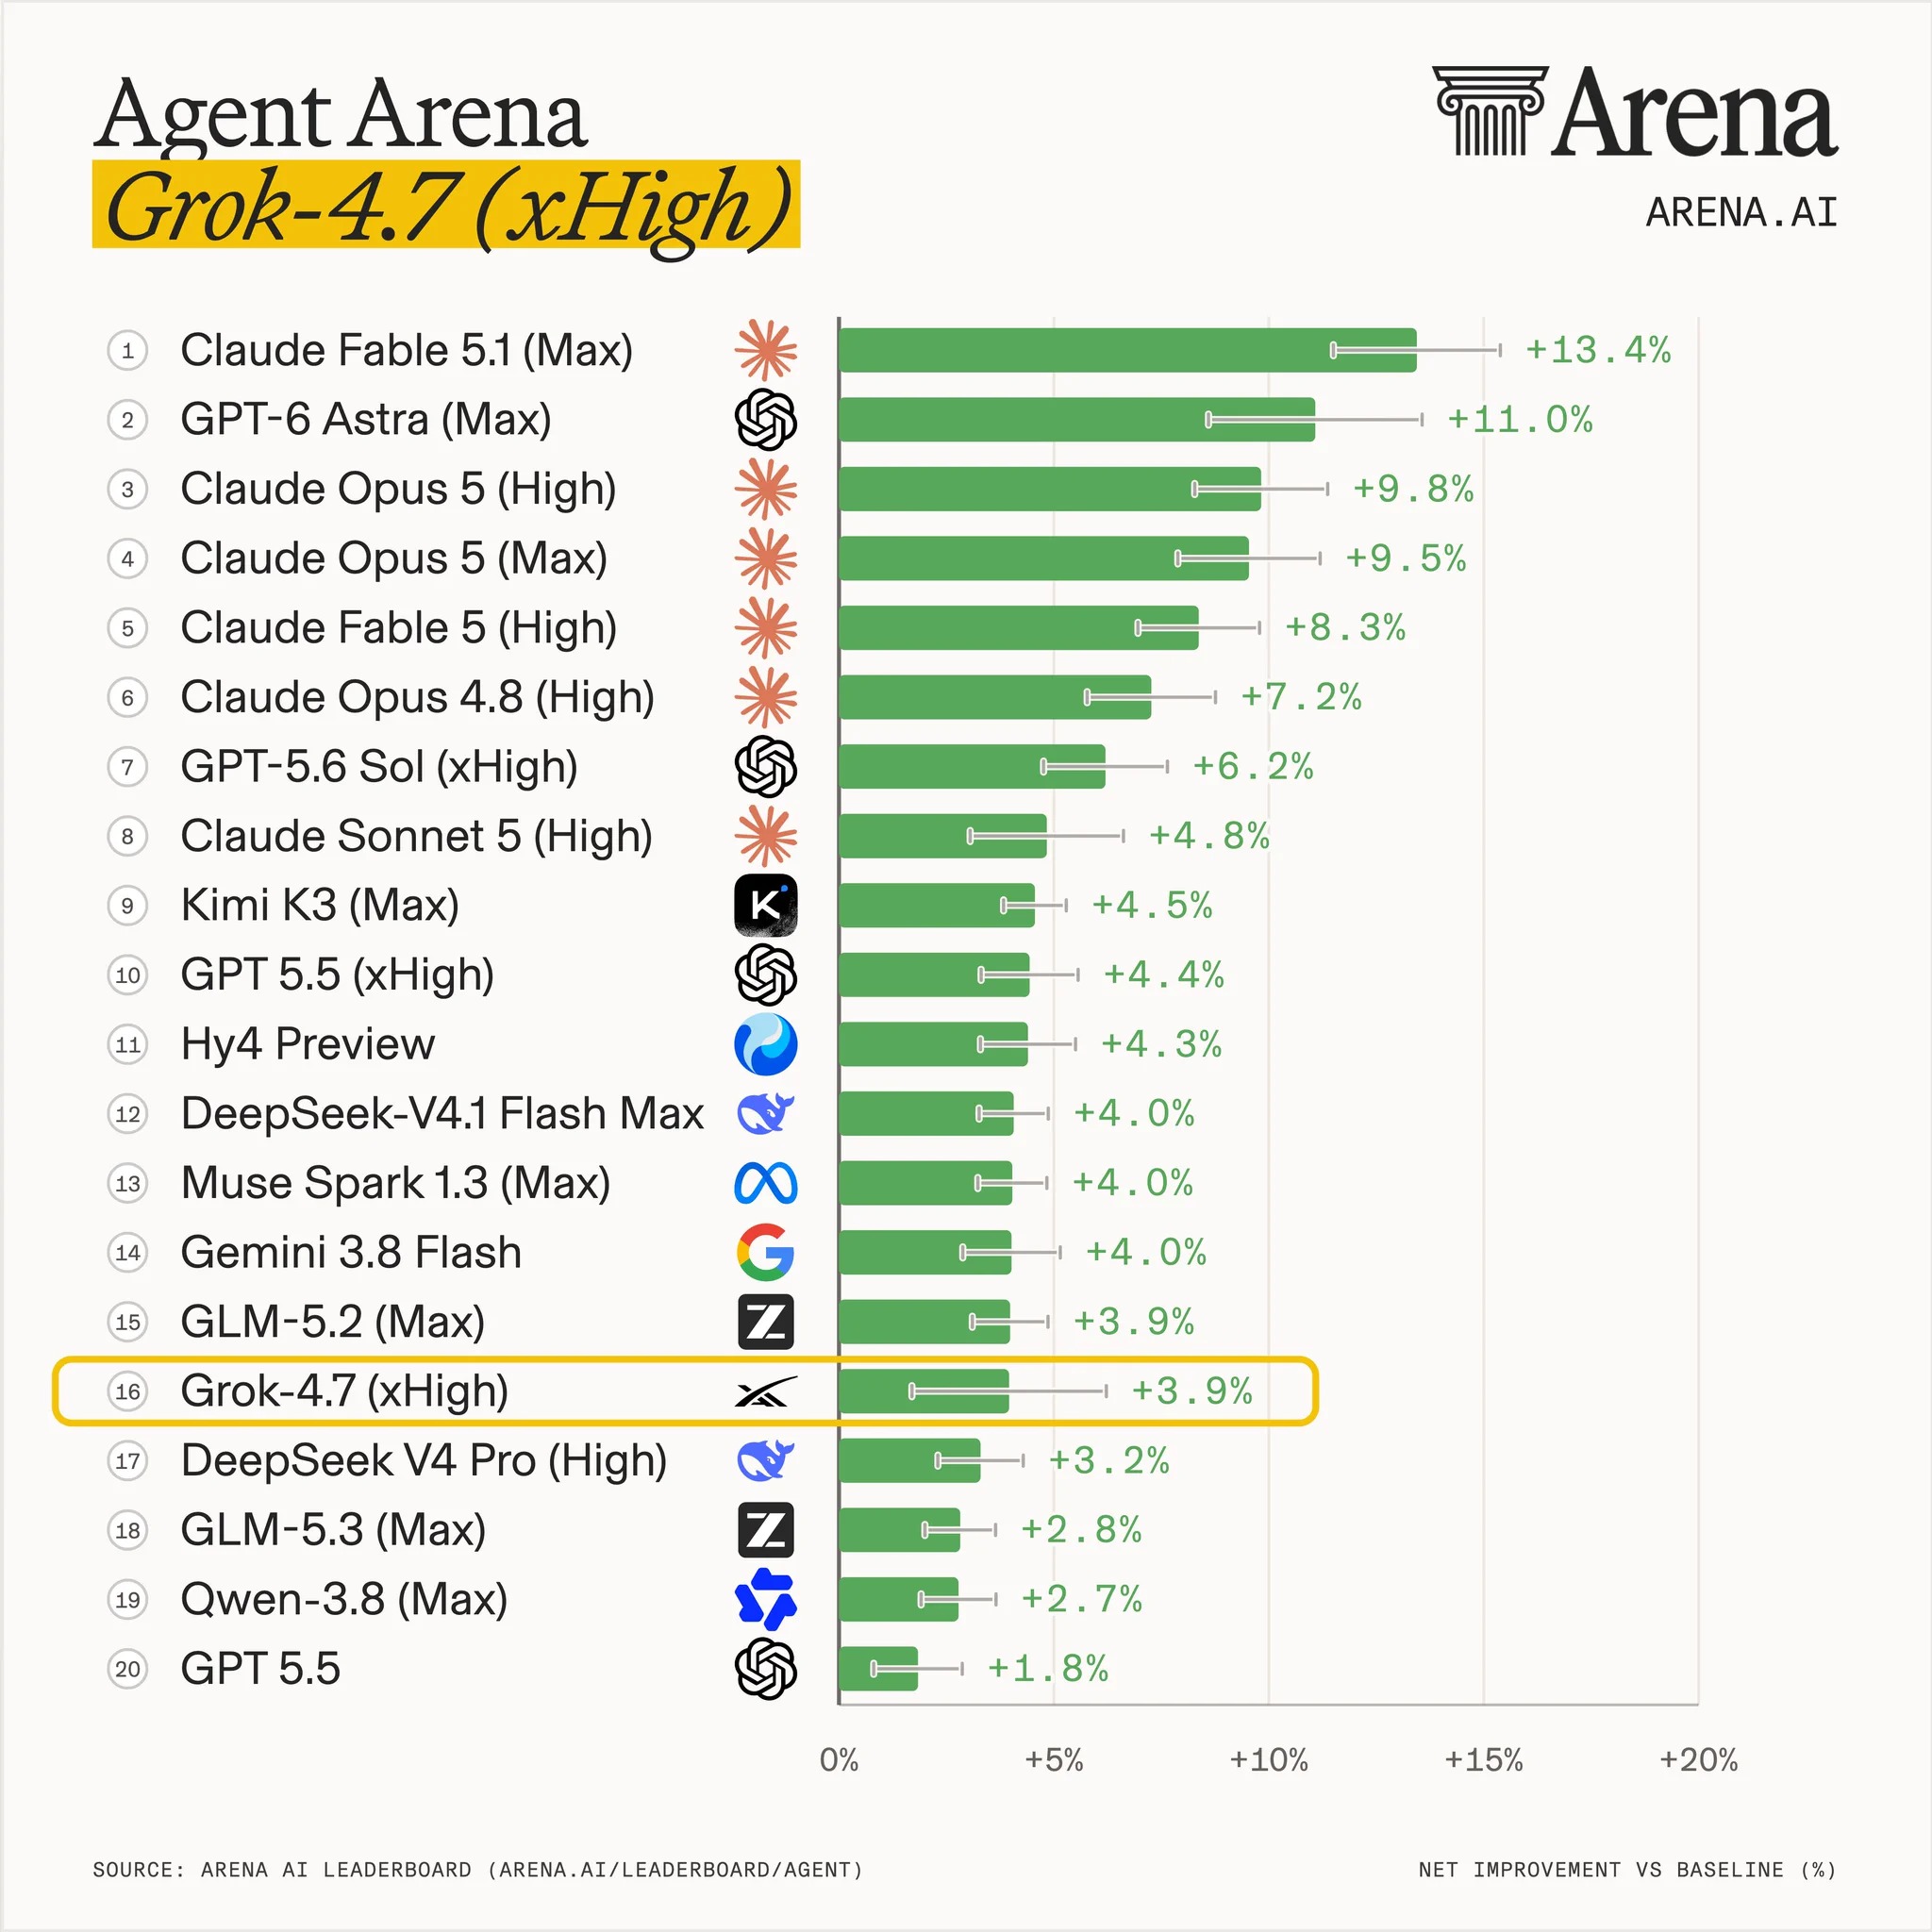
Arena 公布 Grok 4.7 XHigh 的 Agent Arena 结果,净改善指标约3.96%,任务费用中位数约1.14美元。
这次公开比较显示,Grok 4.7 在对应推理档位下取得更高的代理实战成绩,同时单任务消耗也上升。发布者给出的费用中位数为1.14美元。
这里比较的是任务实际 token 消耗形成的总费用,而非 API 单价涨价。各项任务表现并不一致,使用者仍需按自己的任务衡量可靠性和成本。
原始来源:Arena ↗
11 / 开发工具套餐
OpenCode Go DeepSeek 额度转长期
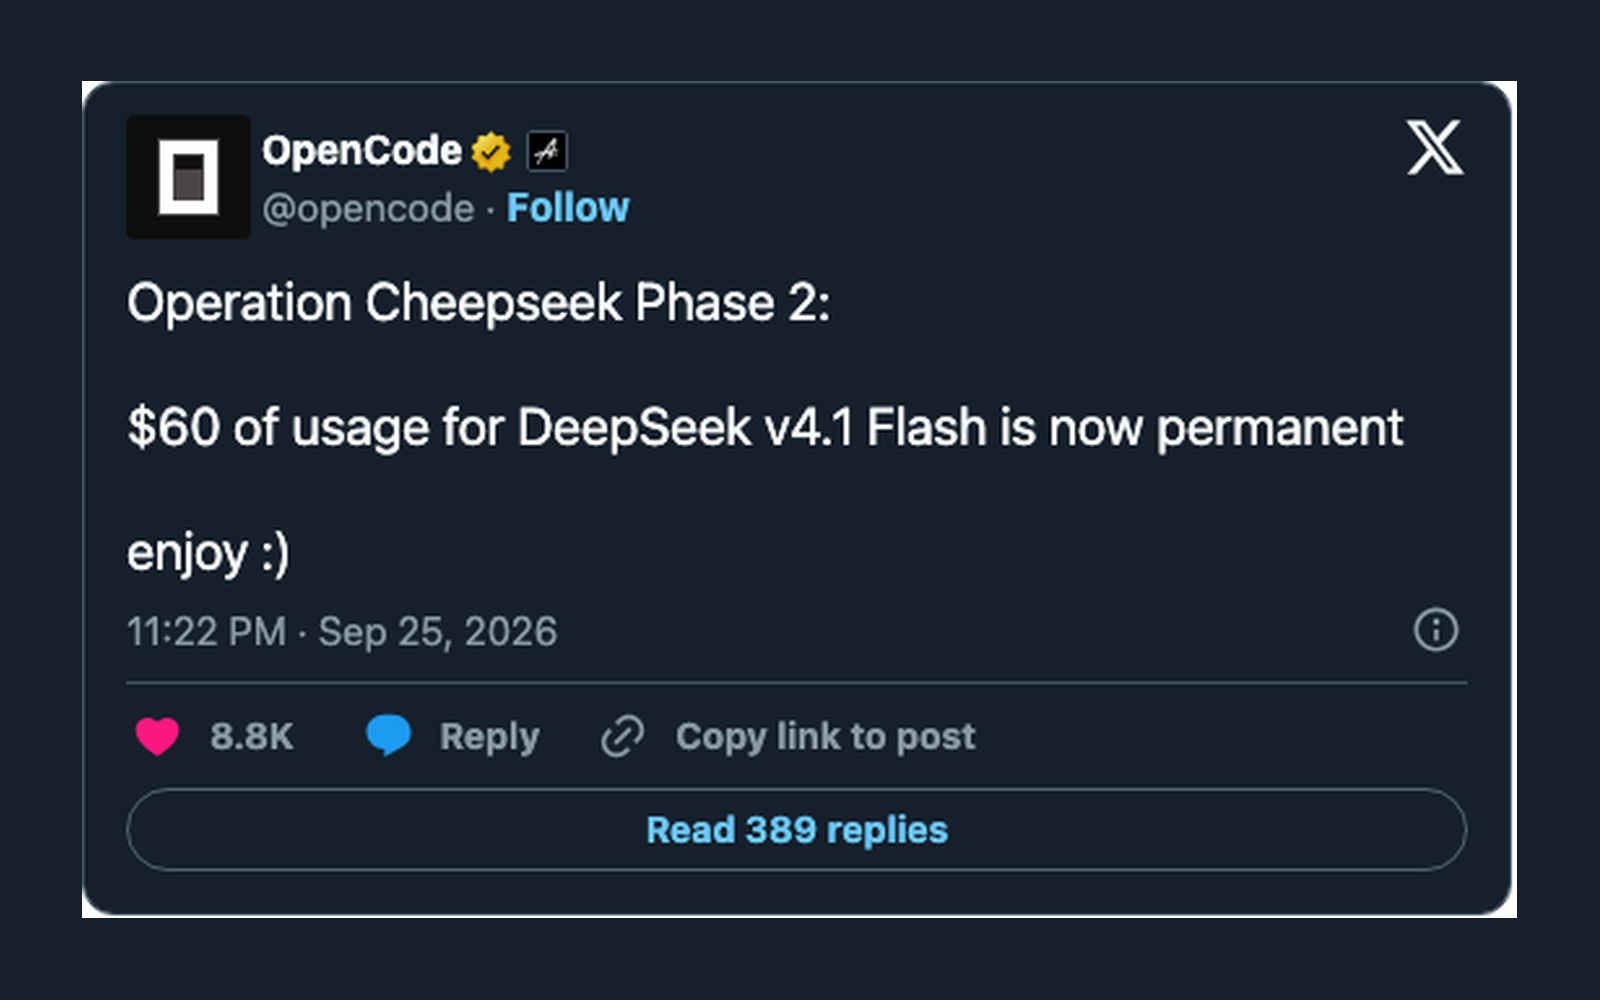
OpenCode 官方宣布,Go 订阅中 DeepSeek V4.1 Flash 每月 60 美元的用量额度由限时活动改为长期保留。
OpenCode Go 是每月 10 美元的开源编程模型订阅。官方帖文称,DeepSeek V4.1 Flash 的 60 美元月度用量额度现在是长期的。
额度按美元计价,另有 5 小时(月额度的 20%)和每周(50%)的分段上限。官方文档 9 月 22 日版本仍标注该活动 9 月 27 日结束,以更新的官方帖文为准。
原始来源:OpenCode ↗
12 / 账号安全功能
ChatGPT 新增 安全活动记录
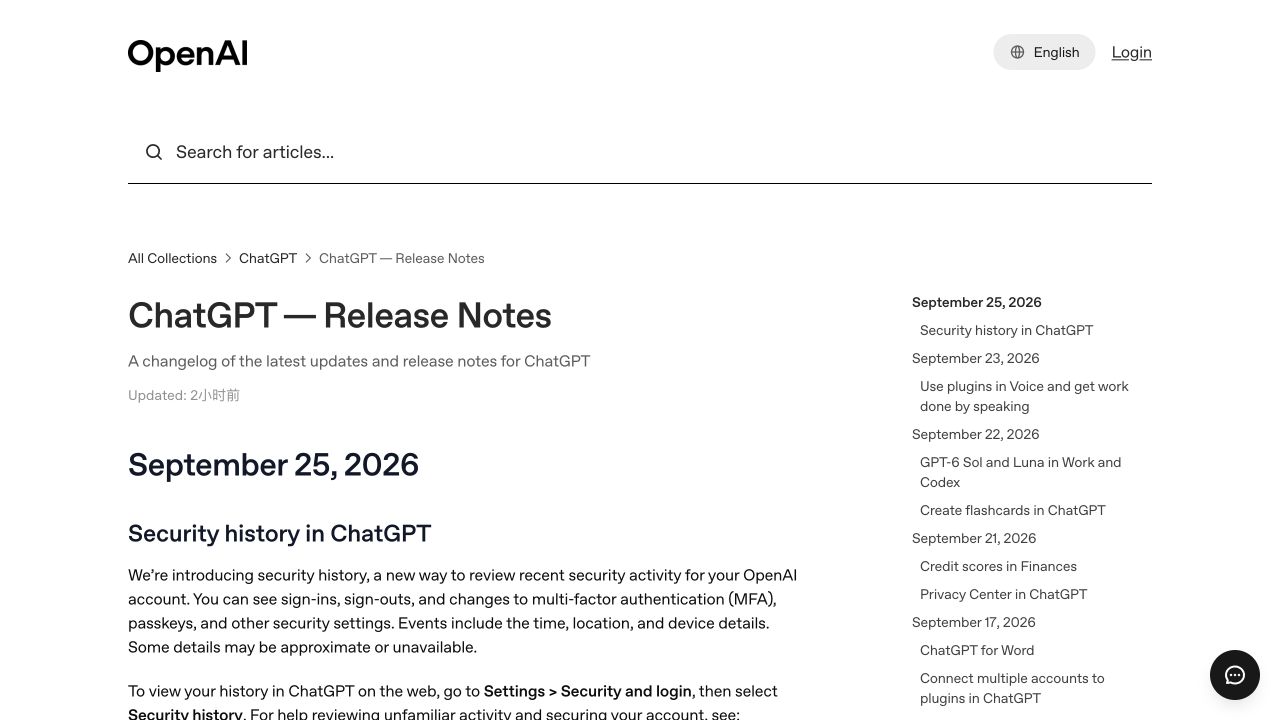
ChatGPT 增加账号安全活动历史,可在网页端安全设置中查看登录和验证方式等变化。
OpenAI 的更新说明介绍了安全活动历史,记录包括登录、登出,以及多因素验证和通行密钥相关设置变化。入口位于网页端 Settings 的 Security 部分。
用户可据此检查是否存在不熟悉的安全活动。活动详情可能不完整,位置等信息也可能为近似值。
原始来源:OpenAI ↗
13 / 代理连接生态
Muse 邀请商家 连接个人 AI 助手
Muse 面向企业和商家开放平台接入邀请,让第三方服务与个人 AI 助手连接。
Muse 通过官方公告邀请企业和商家了解其连接平台,让服务提供方考虑如何把自身能力接入个人助手的工作流程。
公告提供平台入口,但不同服务的接入条件、开放功能与操作权限仍需分别确认。其新变化是给服务方提供接入路径,扩展个人代理可调用的生态。
原始来源:Muse ↗
14 / AI 算力
Colossus 算力 公布现有与后续计划
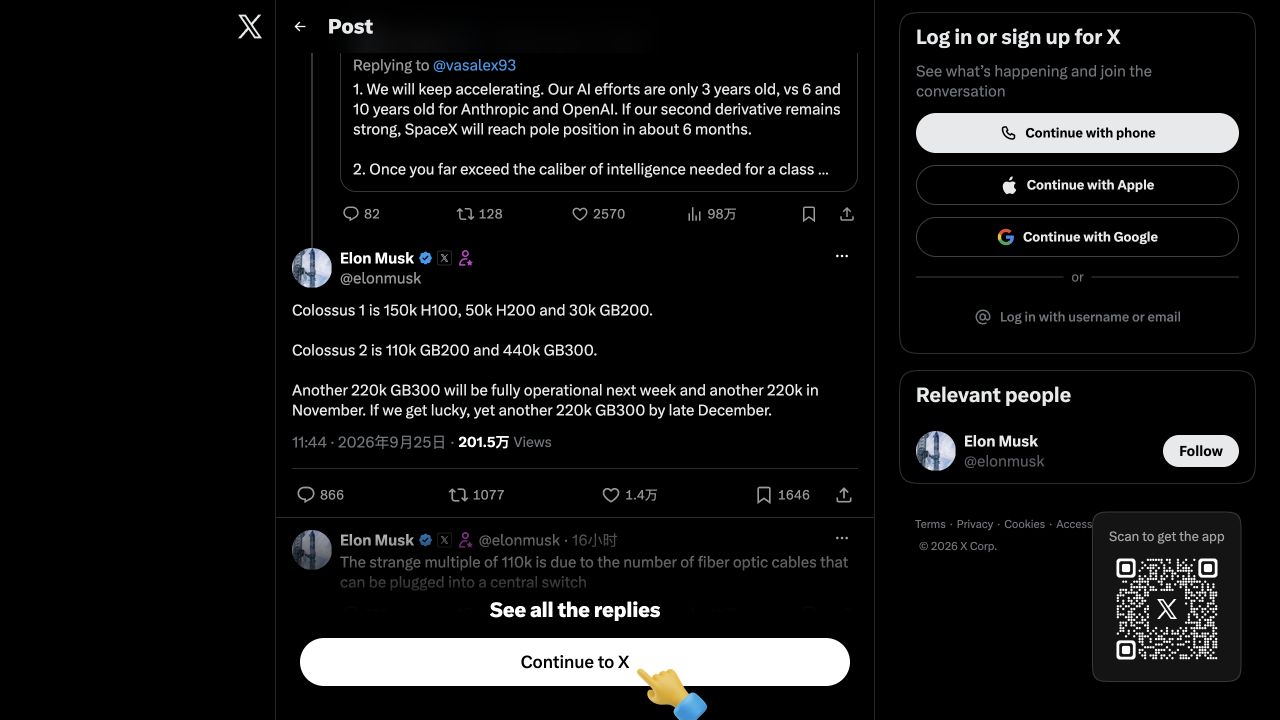
马斯克公开列出 Colossus 1、2 的 GPU 数量,并说明未来数月的扩容计划。
马斯克的公开帖将两座集群按 H100、H200、GB200、GB300 等型号列出数量,当前口径合计约78万块 GPU。
帖子还描述下一周及11月等后续批次,并提到12月可能的扩展。现有设备数字与未来到货计划分别列示,后者仍需随建设进度验证。
原始来源:Elon Musk / xAI ↗
15 / 协作开发代理
Copilot 进 Slack 与 Teams 聊天上下文更完整
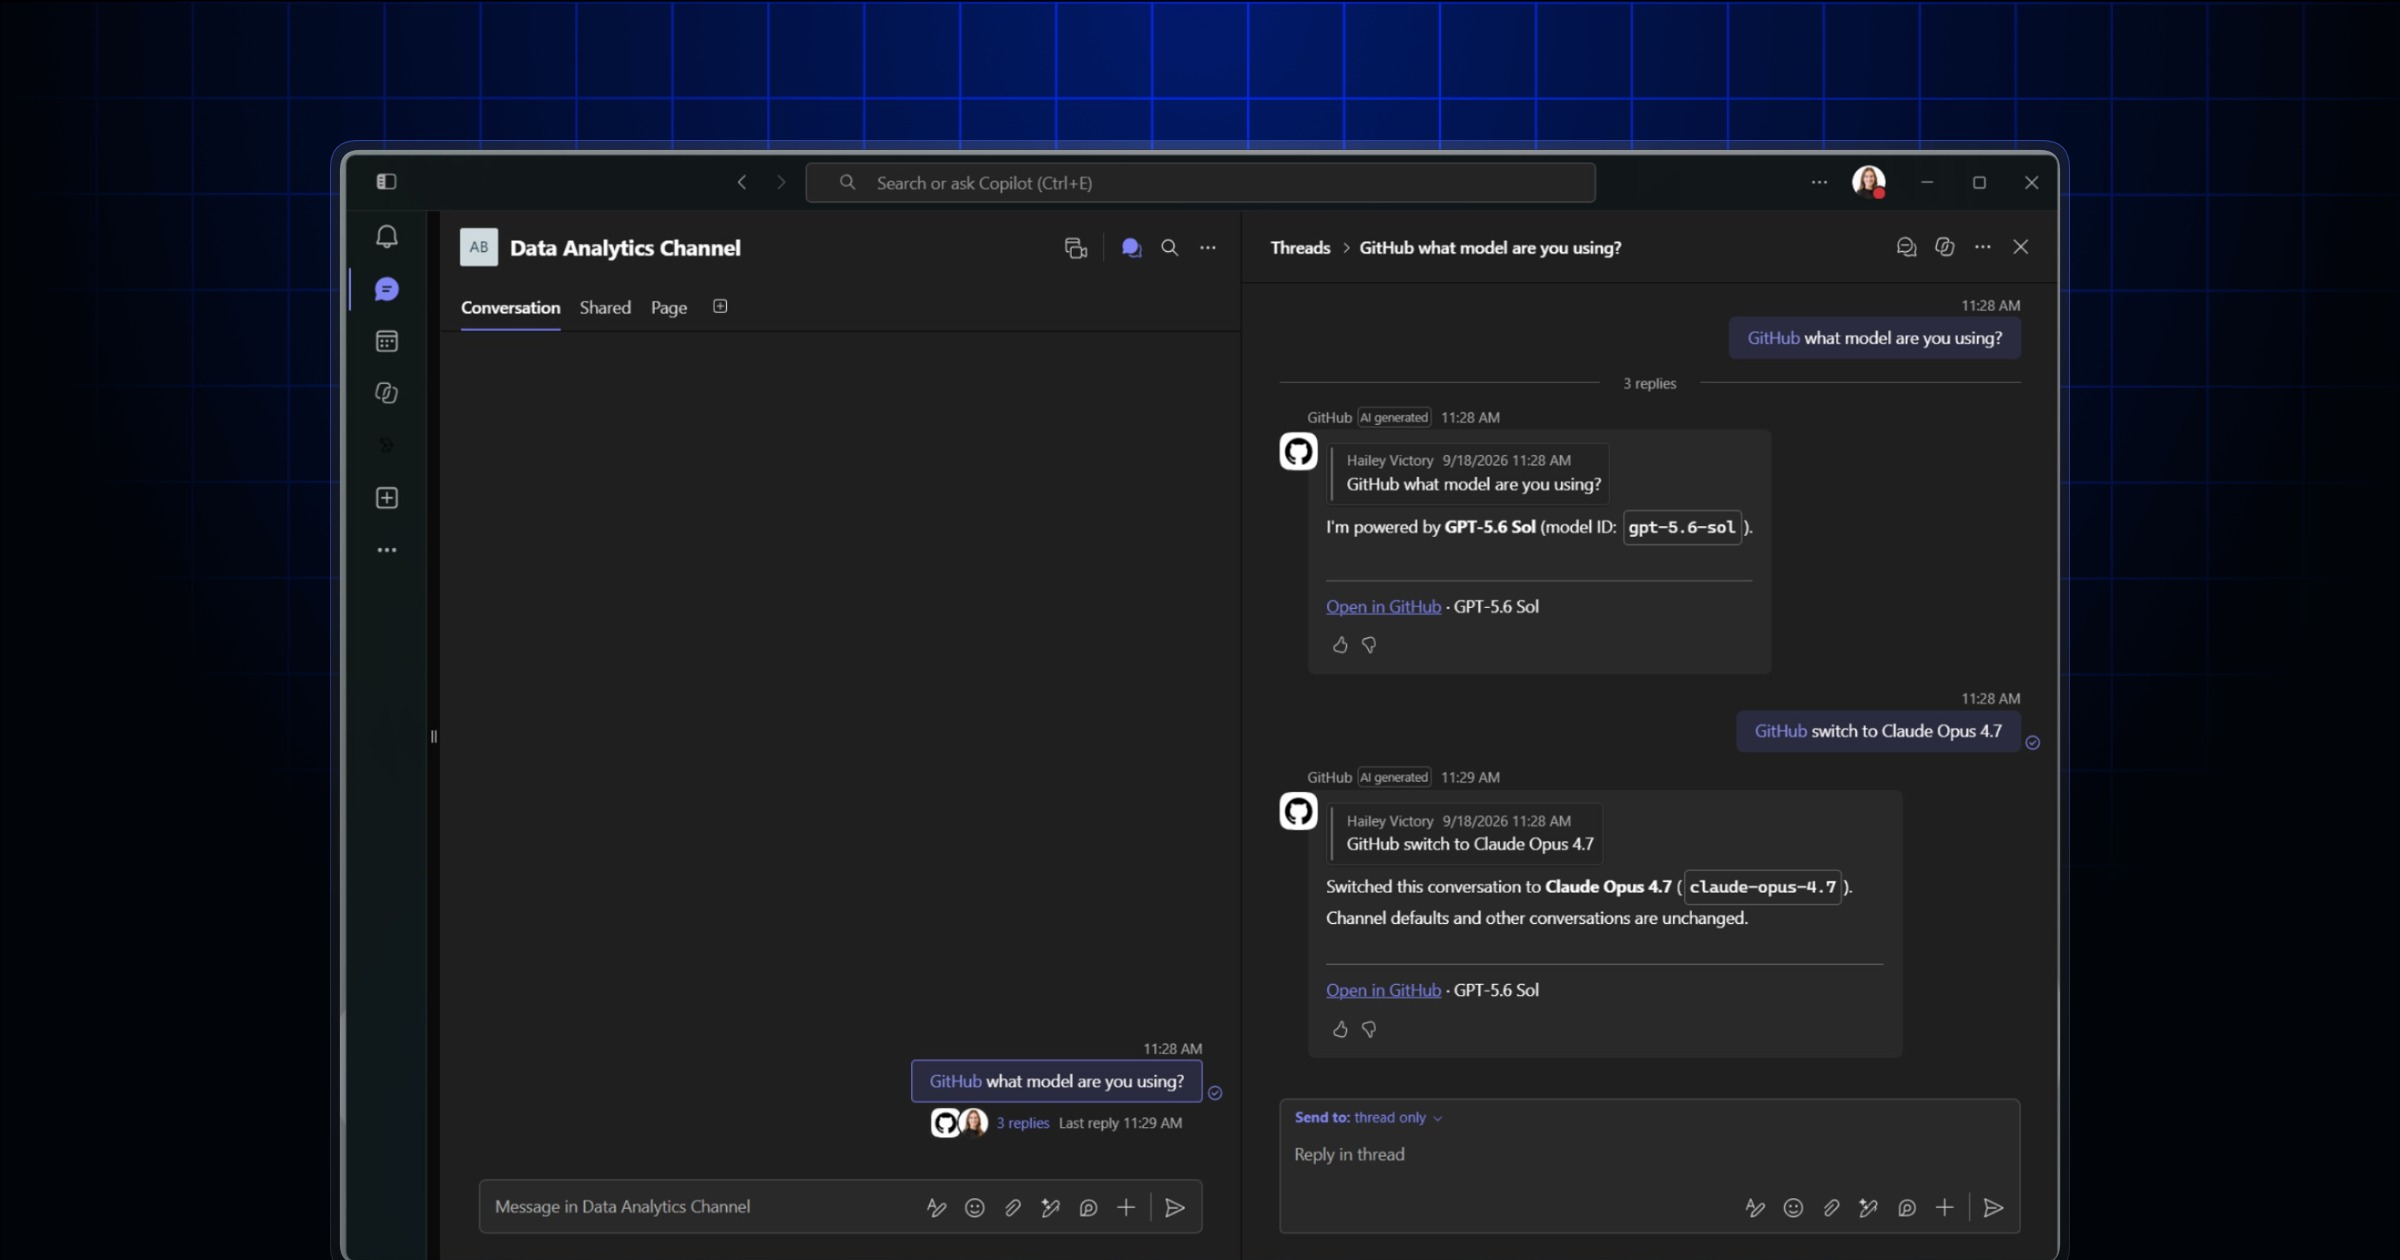
GitHub 更新 Slack 与 Microsoft Teams 中的 Copilot:可使用更多对话上下文,创建任务前检查相似问题,并可在对话中切换模型。
Slack 中可以把支持的文件、附件和消息链接作为上下文;Teams 中 Copilot 可以读取内嵌图片、转发消息以及频道和线程历史。
公开预览面向 Copilot Business 与 Enterprise,用量计入现有额度;部分能力逐步开放,未必已在每个工作区可用。
原始来源:GitHub ↗
国内新闻
16 / 大模型
LongCat 2.5 Preview 百万上下文与兼容接口
美团公布 LongCat 2.5 Preview,官方披露1.6T总参数、48B激活参数,文档提供百万上下文及兼容 API。
LongCat 官方介绍,2.5 Preview 面向多模态理解与工具使用,覆盖终端、浏览器、图形界面和办公场景,并披露1.6T总参数、48B激活参数。
官方文档列出1M上下文、128K最大输出,以及 OpenAI 和 Anthropic 兼容接口。当前是预览版,已有账户可按官方活动规则查看试用额度;本次公告没有据此确认为开放权重发布。
原始来源:LongCat / 美团 ↗
17 / 桌面编码代理
DeepSeek Harness 进入桌面预览阶段
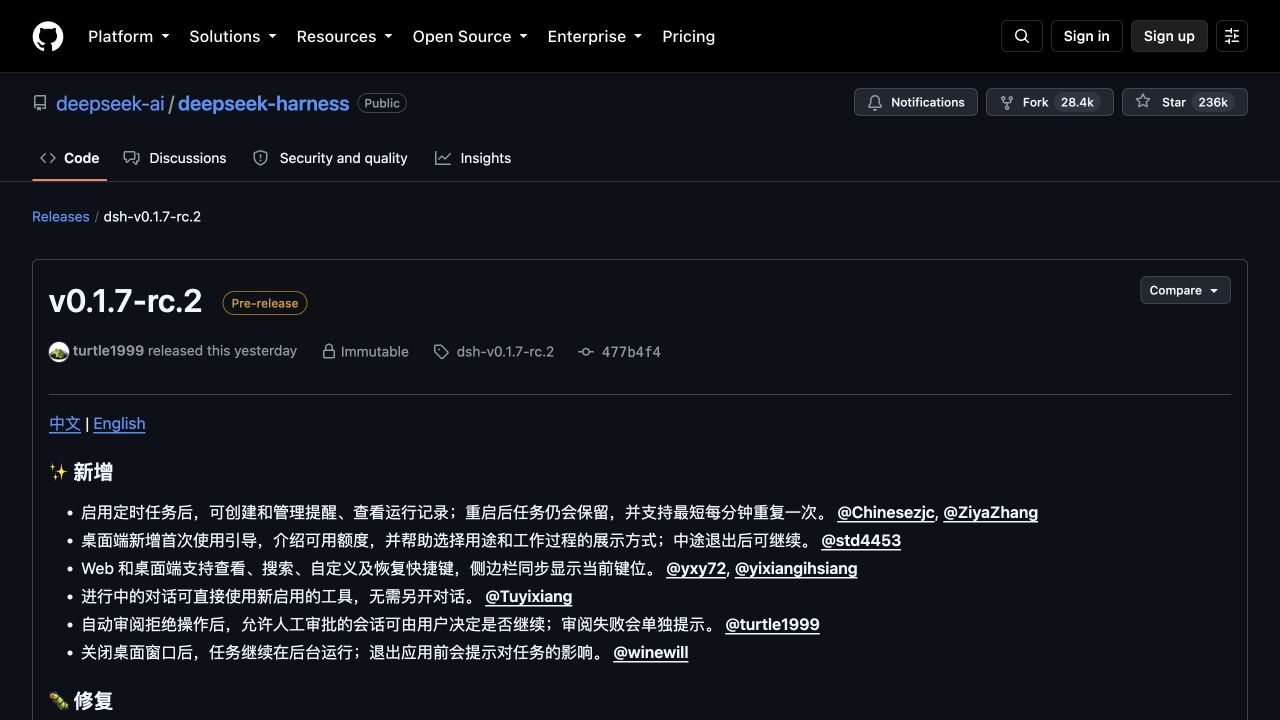
DeepSeek Harness 发布 v0.1.7-rc.2,完善桌面首次启动、后台运行和工具管理,并增加可选的提醒与计划任务。
官方仓库9月24日的候选版本记录改进桌面首次设置、关闭窗口后后台运行,以及会话中启用工具等体验。对应桌面安装包也已出现在官方发布链路。
提醒和计划任务支持跨重启保存,属于可选择启用的能力。当前为 release candidate,应按具体版本了解安装环境和功能状态。
原始来源:DeepSeek ↗