OPC 中国 · AI 日报
DeepSeek插件工作台、OpenCode浏览器操作与Pro额度|11月9日AI日报
11条AI动态:DeepSeek Harness社区插件与扶持意向征集、OpenCode Browse、ChatGPT Pro额度、Grok Bot修复方向及模型推理进展。
本节目由AI辅助整理、配音与数字人呈现;新闻依据原始发布核查,原图与官方演示注明出处。
本期目录
国内新闻
01 / 今日头条
DeepSeek Harness 插件走进日常工作
团队公开四款可在插件安装页按包名查找的案例,包括内容工作台、设计、上下文透视与论文阅读,并收集插件作者扶持意向。
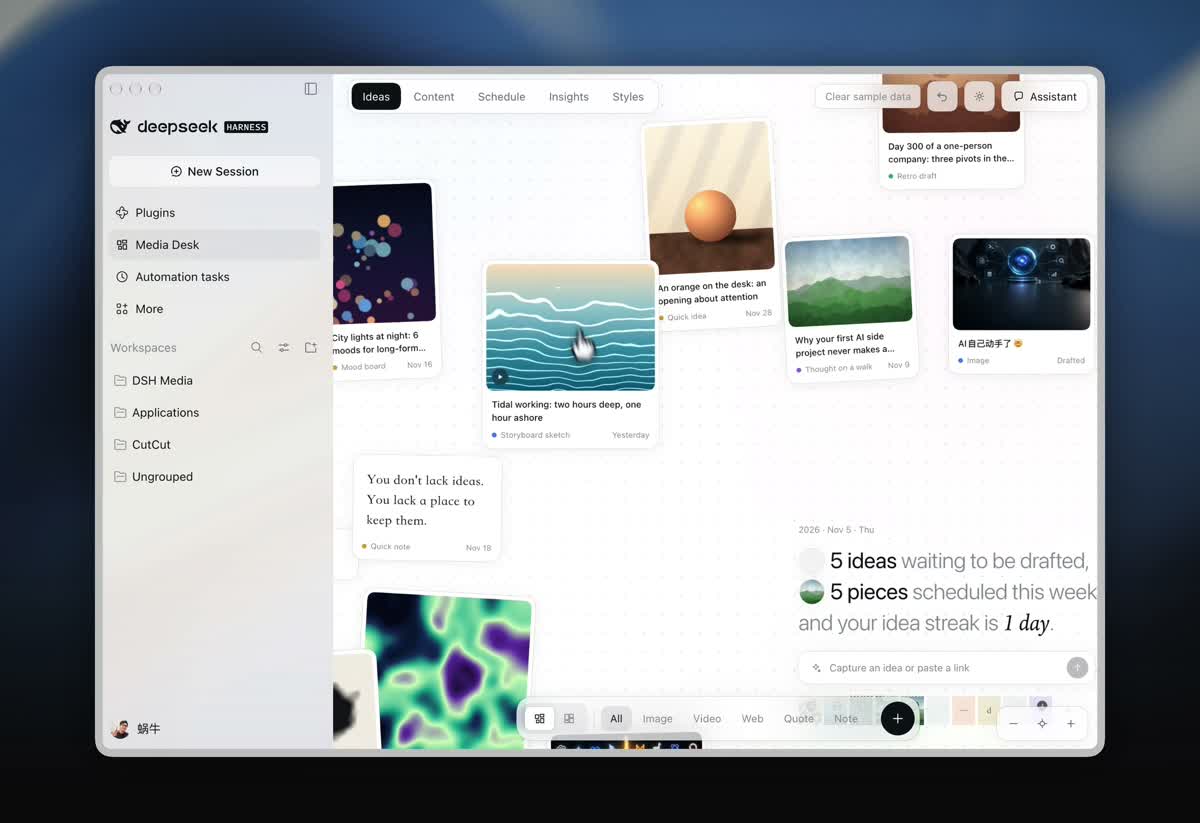
今天的头条,DeepSeek Harness 把社区插件怎么用、作者如何获得支持,讲得更具体了。团队在十一月八日晚发布长文,介绍四款社区作品。内容工作台把记灵感、写脚本、做封面和分镜放到一起;设计插件把文章变成网页、图片卡或封面,还能保存作品继续修改。另两款分别让你查看智能体的上下文变化,以及在同一个界面阅读论文、翻译和记笔记。想试用,可以在插件安装页输入原文列出的包名。对创作者来说,这些案例展示了把零散操作组合成日常工作台的做法。团队也准备提供词元额度、技术交流和推广支持,目前表单收集的是初步意向,参与规则和具体支持内容会在计划正式启动时公布。官方插件市场也在建设计划中。团队强调,在一切皆插件的设计下,内置功能同样可以被第三方插件替换。
原始来源:DeepSeek Harness ↗
国外新闻
02 / 国外动态
OpenCode Browse 连接现有浏览器
Chromium 扩展和 MCP 服务可使用当前标签、登录态与扩展,支持截图、录屏、网络记录和登录交接,也可接其他 MCP 客户端。
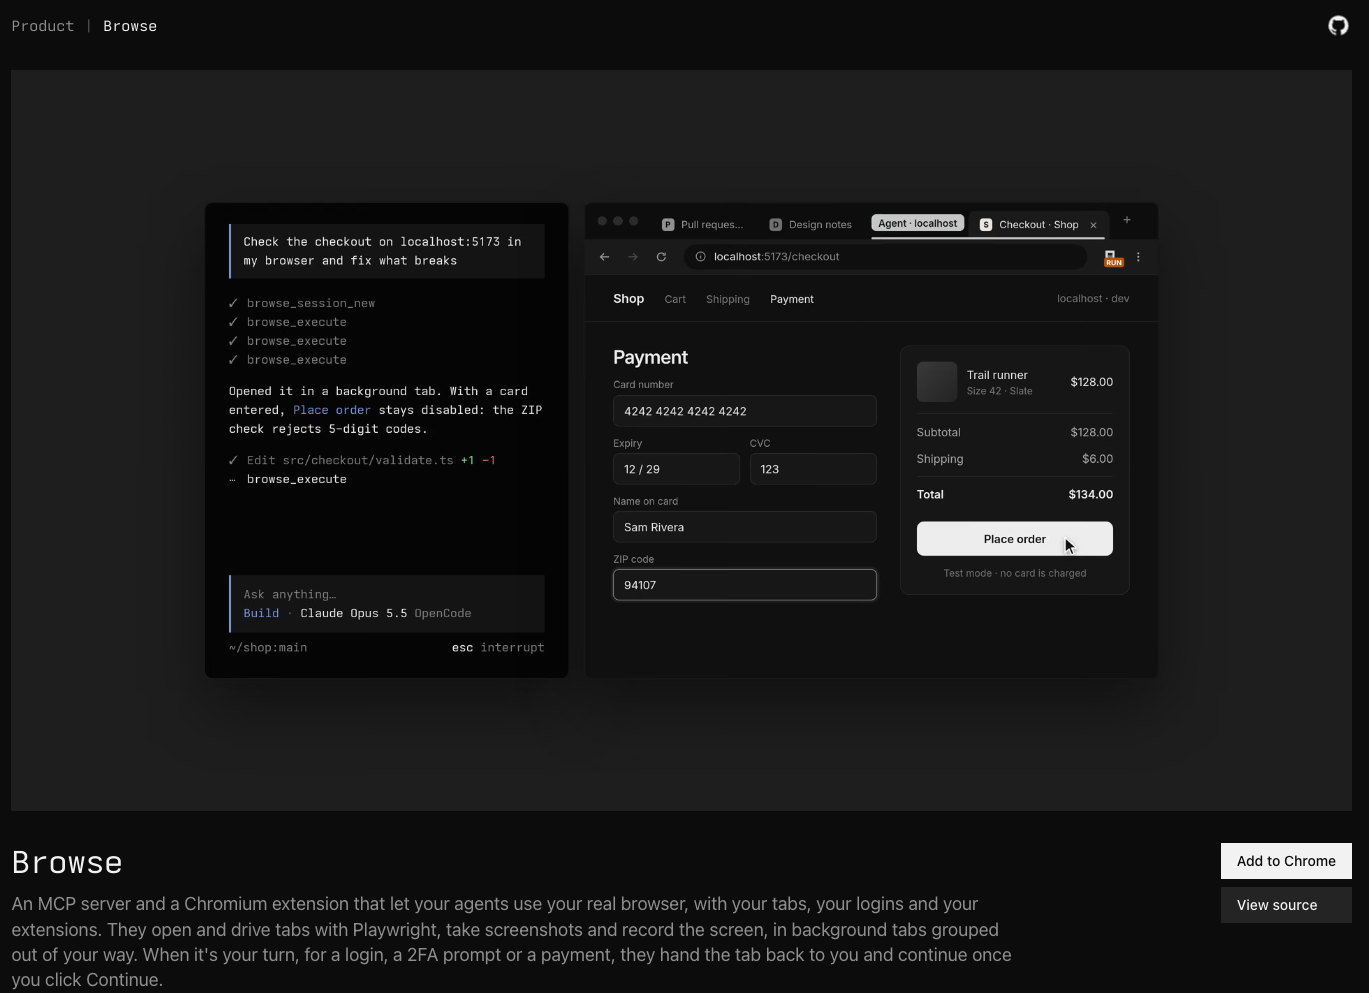
接着看国外动态。OpenCode 的 Browse,让编程助手使用你正在工作的真实浏览器。它由 Chromium 扩展和 MCP 服务组成,可以沿用已有标签、登录状态和扩展。智能体在后台标签组里操作页面,还可以截图、录屏和保存网络请求记录。遇到登录、双重验证或支付环节,会把标签交回给你,完成后再继续。这个能力也面向其他 MCP 客户端,不只限于 OpenCode。对做网站、测试流程和整理资料的小团队来说,现有登录态能减少重复准备。安装时先从官方扩展入口开始,也可以用站点白名单限定会话能访问的范围。
原始来源:OpenCode ↗
03 / 国外动态
ChatGPT Pro 三档额度再说明
Thibault Sottiaux 称 Pro 100、200、500 分别约为 Plus 用量的 10、20、50 倍,三档无五小时限制,Ultrafast 归 Pro 500。
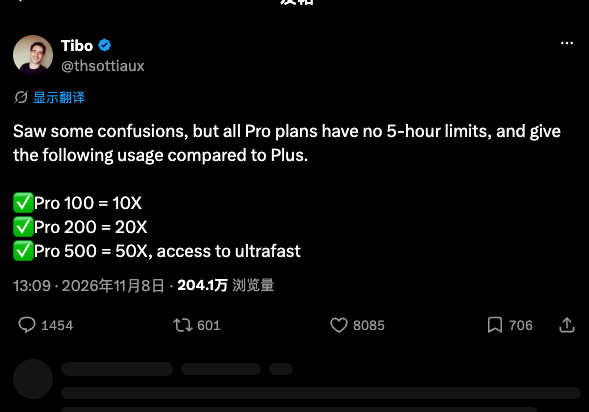
常用工具的额度也有一条说明。OpenAI 团队成员 Thibault Sottiaux 在十一月八日重申,Pro 一百、二百和五百三个档位,对应的用量约为 Plus 的十倍、二十倍和五十倍,三档都没有五小时用量限制,Ultrafast 则属于 Pro 五百。这里说的是现有档位规则,并非当天又推出三个新套餐。官方帮助中心列出的月价分别是一百、二百和五百美元,也说明实际能完成多少工作,取决于模型、任务和设置。尤其要分清,Work 与 Codex 的额度,和聊天中 Pro 模型的每周消息上限,是分别计算的。没有五小时限制,并不等于所有模型都没有上限。
04 / 国外动态
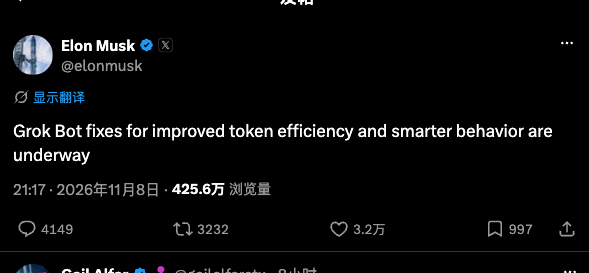
Grok Bot 正在改善效率与行为
马斯克公开表示,Grok Bot 正在做改善词元效率和行为的修复。
Grok Bot 这边,马斯克在北京时间十一月八日晚九点十七分表示,改善词元效率和行为的修复正在进行。对使用智能体的人来说,词元消耗和行动是否合理,都直接影响一次任务的体验。原帖目前只给出了这两个修复方向,没有列出上线日期、适用套餐或具体节省幅度。因此这条消息的新增信息,是团队正在处理这些问题;具体效果还需要等更新落地后再观察。
05 / 国外动态
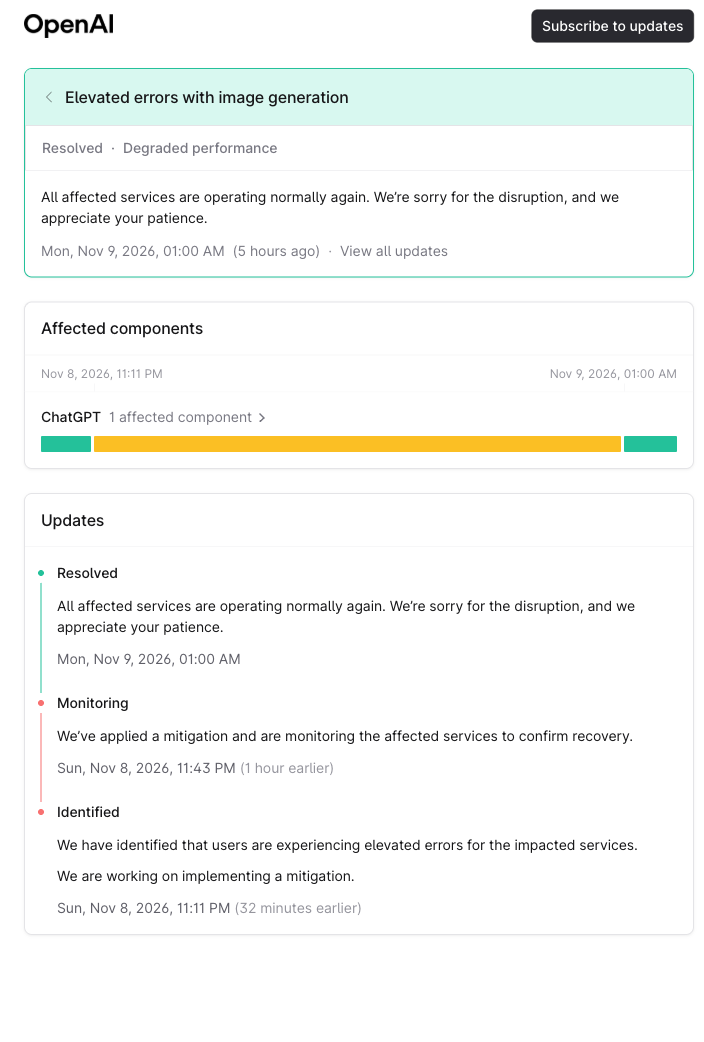
ChatGPT 图像生成 故障已标记恢复
OpenAI 状态页记录图像生成组件出现较多错误,之后标记恢复。页面首条确认北京时间 11 月 8 日 23:11,9 日 01:00 标记恢复。
再看一条服务提醒。OpenAI 状态页记录,ChatGPT 图像生成曾出现错误率升高。换算成北京时间,首条确认是十一月八日晚上十一点十一分,十一点四十三分进入缓解后的观察阶段,十一月九日凌晨一点标记恢复。也就是说,昨天深夜生成图片失败的用户,可以留意这次故障记录。页面列出的受影响组件是 ChatGPT 图像生成,没有给出受影响人数。官方也提醒,可用性是汇总指标,具体体验会因订阅档位和所用功能而不同。
原始来源:OpenAI Status ↗
06 / 国外动态
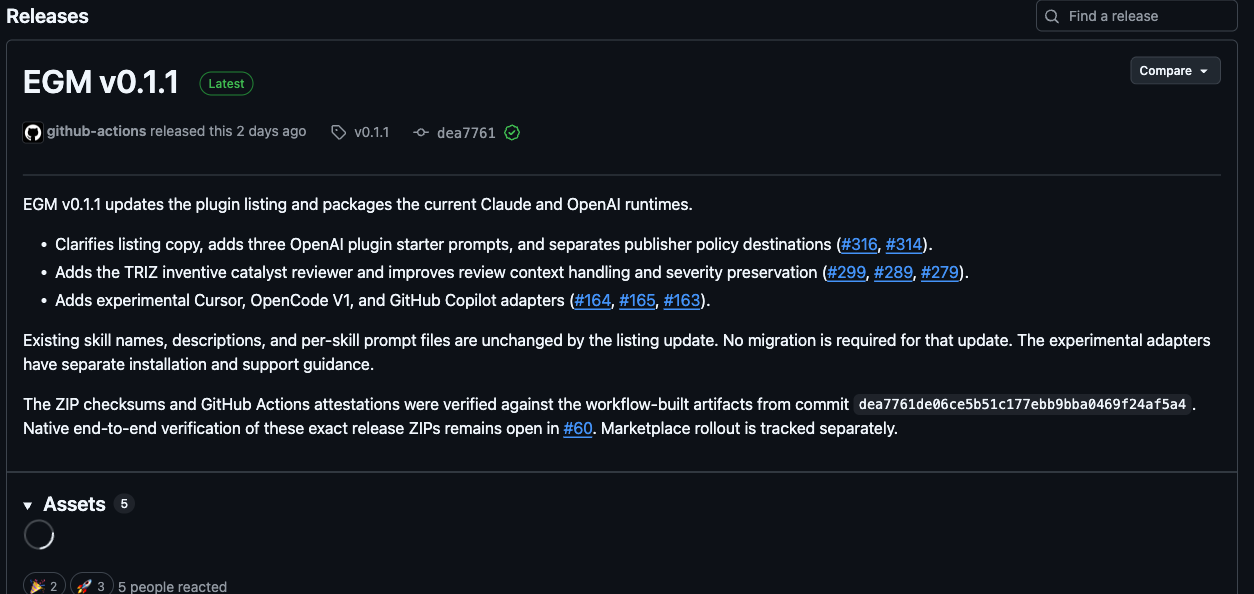
EGM 0.1.1 扩展实验适配
EGM v0.1.1 给三类编程助手新增实验适配,并加入新的评审角色及上下文处理改进。
Google 组织下的开源项目 EGM 发布了零点一点一版。它把设计文档作为协作对象,让新的独立上下文审查文档和引用,帮助发现前面对话里容易忽略的问题。这次更新增加 Cursor、OpenCode V1 和 GitHub Copilot 的实验适配,还增加 TRIZ 创新评审角色,改进审查上下文和问题严重程度的保留。需要留意的是,发布说明把这些适配明确标为实验性质,发行压缩包在原生宿主中的完整端到端验证仍未完成,市场上架也是单独推进的。它是开源项目,不是 Google 正式支持的产品,适合愿意测试工作流的开发团队。
原始来源:Google 开源项目 ↗
07 / 国外动态
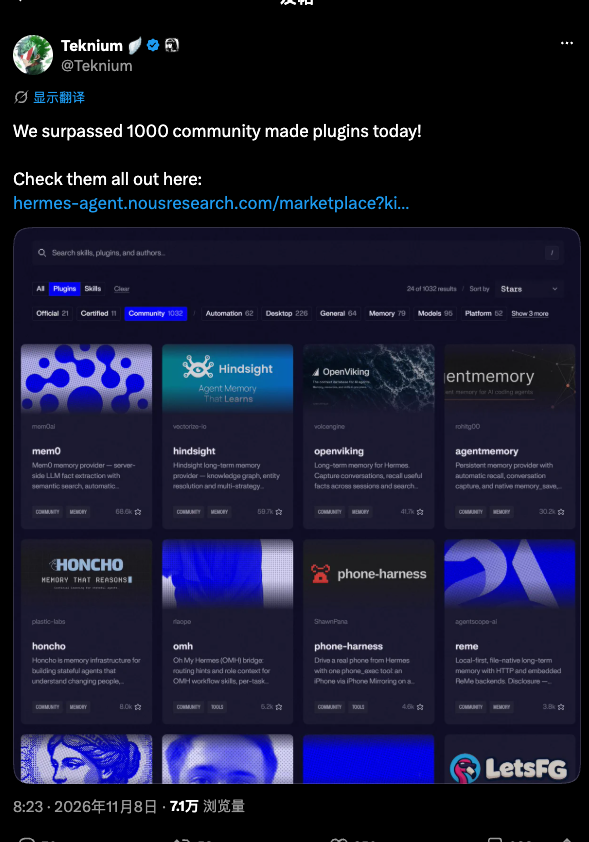
Hermes 社区插件 维护者称突破千款
项目维护者 Teknium 公布社区插件里程碑,市场公开可浏览技能与插件。
另一边,Hermes 的社区生态也在扩展。项目维护者 Teknium 在十一月八日表示,社区制作的插件已经超过一千款,并给出了公开市场入口。对用户来说,可以先从自己要解决的任务出发,查找有没有现成工具,再看功能说明、发布者和所需权限。这里的一千款,是维护者对社区插件的统计口径,不能直接等同于市场某一个筛选分类显示的数量。这个里程碑说明社区选择更多了,而某个插件是否适合自己的工作流,仍要结合它的功能和维护情况判断。
08 / 国外动态
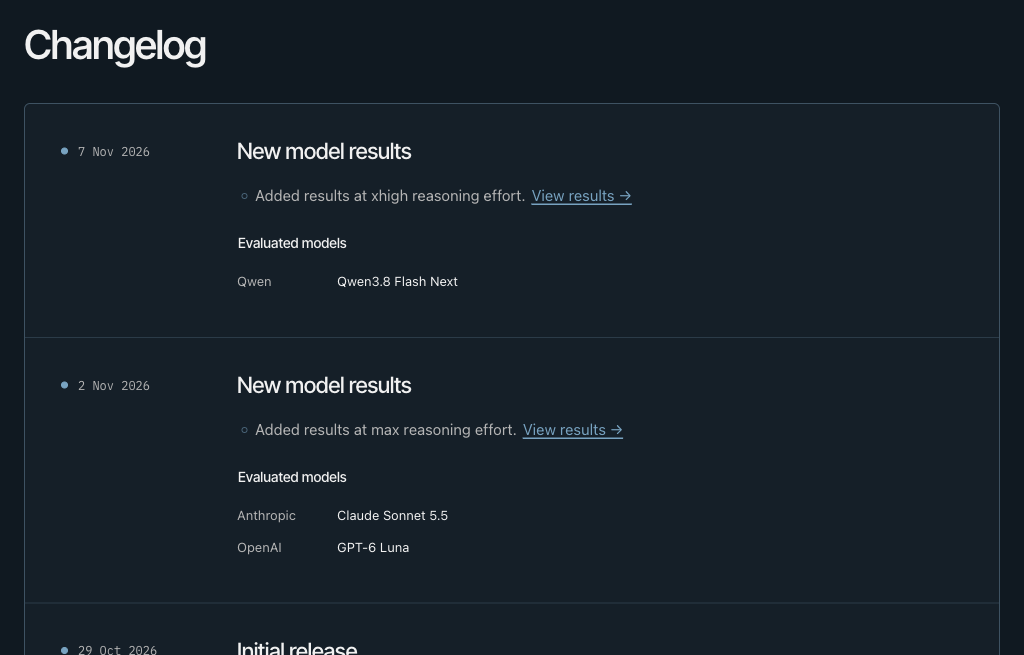
MaxxBench 更新 加入千问高推理档
11 月 7 日更新增加 Qwen3.8 Flash Next 的 xhigh 结果;评测对 89 道 DeepSWE 题改动要求或起始代码,观察代理是否跟随变化。
评测方面,MaxxBench 在十一月七日加入了 Qwen 三点八 Flash Next 的超高推理档结果。这个评测由 unLAP 团队发布,做法是在八十九道 DeepSWE 题目上修改需求或起始代码,观察编程智能体能否跟着新要求调整,而不是沿用旧解法。官网记录的首版发布时间是十月二十九日,因此本期的新变化是新增模型配置的结果。对于选编程模型的人,它提供了观察需求适应能力的一个角度。分数对应的是这套改动后的固定题组,不等于你日常项目的编码成功率。
国内新闻
09 / 国内动态
Qwen Code 0.27.0 多个问题一起处理
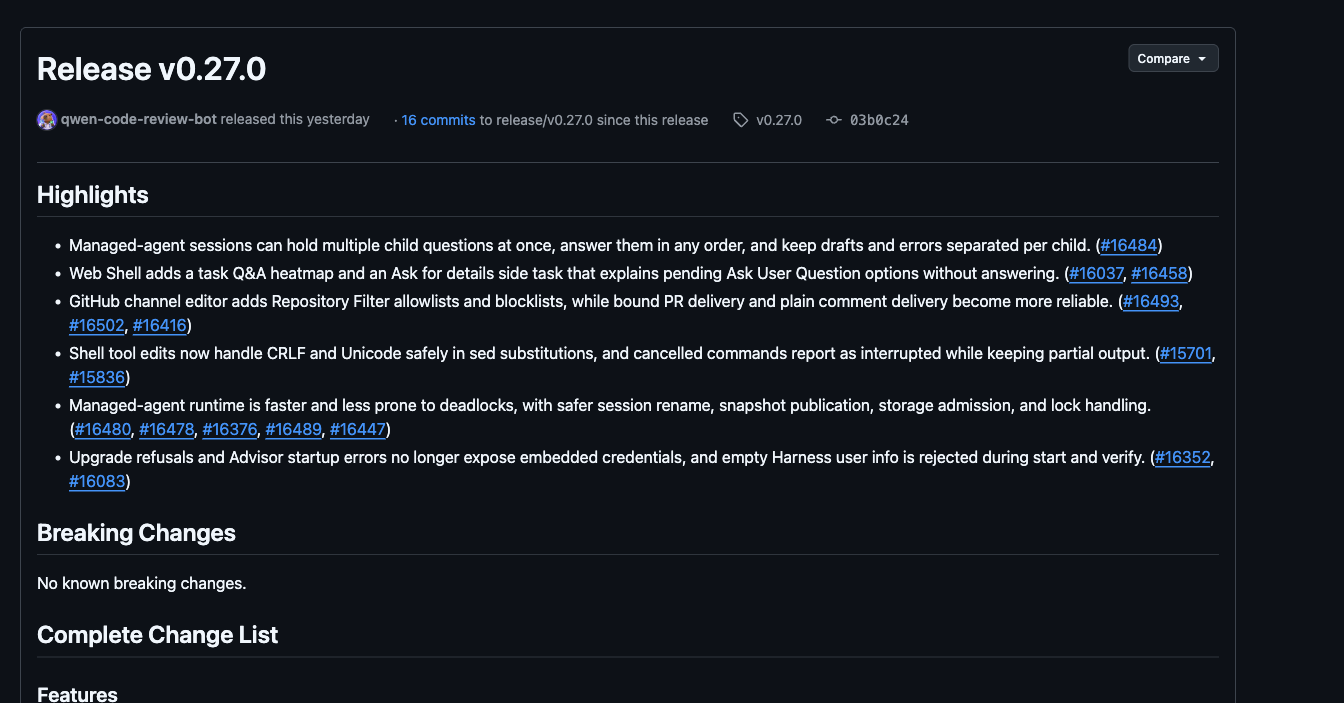
托管智能体可同时保留多个子任务问题并任意顺序回答,Web Shell 可让侧任务解释选项,GitHub 通道加入仓库允许和阻止清单。
国内动态先看 Qwen Code。零点二十七点零版让托管智能体会话可以同时保留多个子任务的问题,用户按任意顺序回答,各个子任务的草稿和错误信息分别保存。比如几个任务都在等待你选择方案,就不必只处理最先出现的那个。Web Shell 还增加询问细节的侧任务,可以解释待选项,但不会代替你作答。GitHub 通道则加入仓库允许清单和阻止清单,帮助限定通知范围。这几项分别作用于托管会话、Web Shell 和 GitHub 通道,使用时要找到对应入口。
原始来源:Qwen Code ↗
10 / 国内动态
腾讯 DSpine 加速千问模型推理
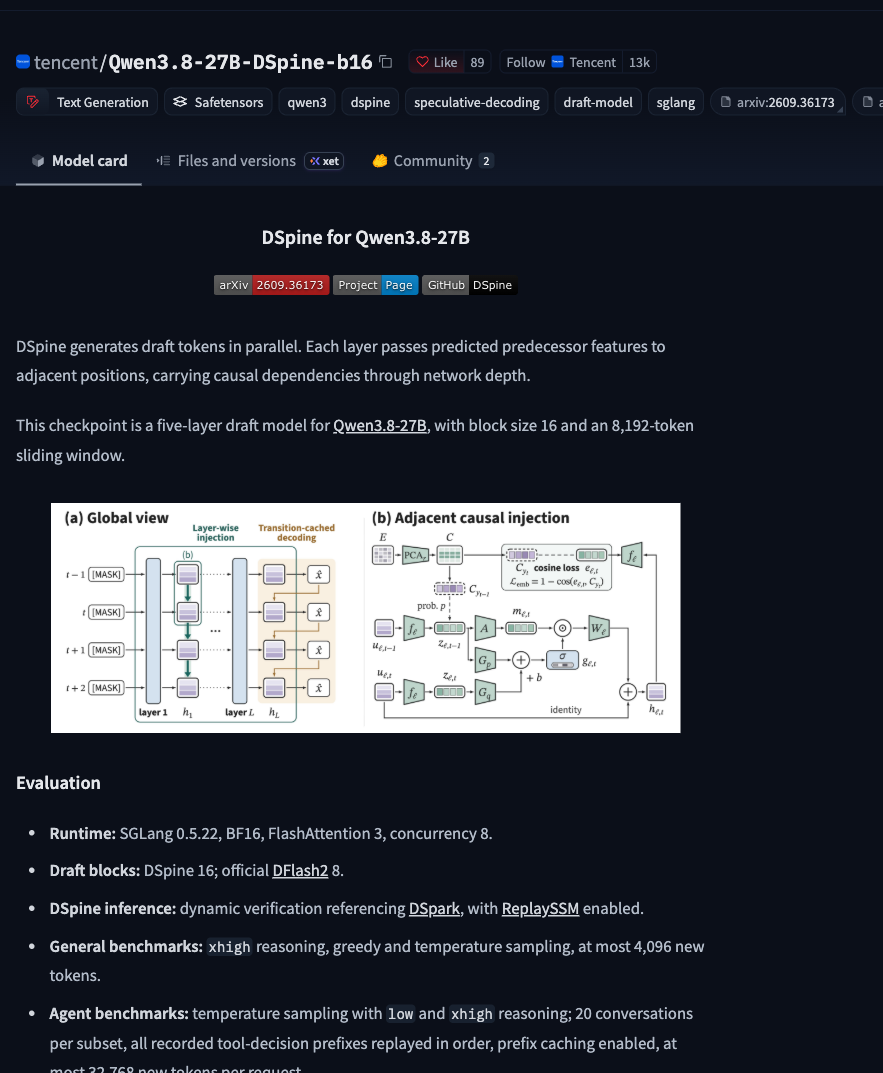
新发布五层草稿模型,需搭配 Qwen3.8-27B 和支持的 SGLang 推理配置,模型卡报告指定并发回放任务中较自回归基线约 2.71 至 3.84 倍吞吐。
腾讯公开了面向 Qwen 三点八二十七 B 的 DSpine 草稿模型。可以把它理解为辅助生成的一环:先并行提出候选词元,再由底模验证,减少逐个生成的等待。这份模型卡给出的检查点有五层,块大小为十六,需要配合底模和支持它的 SGLang 配置使用。官方列举的智能体并发回放测试中,相对自回归生成基线,吞吐约为二点七一到三点八四倍。这是指定任务、推理档和运行配置下的结果,重点面向自行部署模型的团队。草稿模型本身不能独立替代原来的底模。
原始来源:腾讯 ↗
11 / 国内动态
Step 5 托管优化 Together 称吞吐超三倍
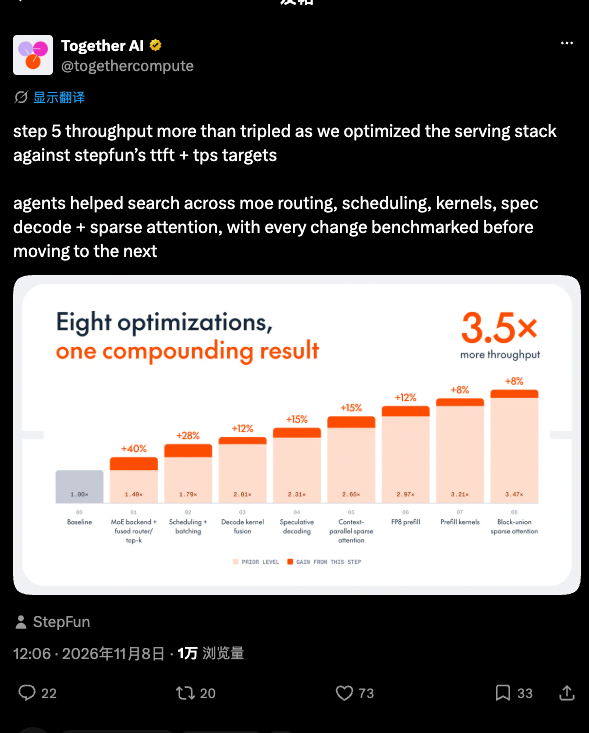
托管方称围绕阶跃星辰的首词时延和输出速度目标优化路由、调度、算子和推理流程后,Step 5 吞吐较自身优化前提高超过三倍。
最后是阶跃星辰模型的托管进展。Together AI 表示,围绕阶跃星辰对首词时延和输出速度的目标,优化服务端推理流程后,Step 五的吞吐比自身优化前提高了三倍以上。团队说,智能体参与了专家路由、调度、算子、推测解码和稀疏注意力等方向的搜索,每项变化都先做基准测试,再推进下一步。这是托管供应商公布的工程结果,公告没有承诺所有用户都获得同样速度,也没有宣布降价。对于通过服务商调用模型的团队,这条进展体现了底层模型之外,推理服务优化也会影响实际体验。
原始来源:阶跃星辰 / Together AI ↗